NOVIDADE DE IA · 23/09/2026
Opus 5.5 e o "pacing": por que a Anthropic lança IA de ponta com travas
O Opus 5.5 é comparável ao Claude Mythos 5.1 em biologia e cibersegurança — por isso saiu com salvaguardas de nível Fable 5.1 e acesso verificado para essas áreas. Na mesma semana, Dario Amodei defendeu cadenciar o progresso da IA. O que isso significa na prática e o que muda para quem usa.
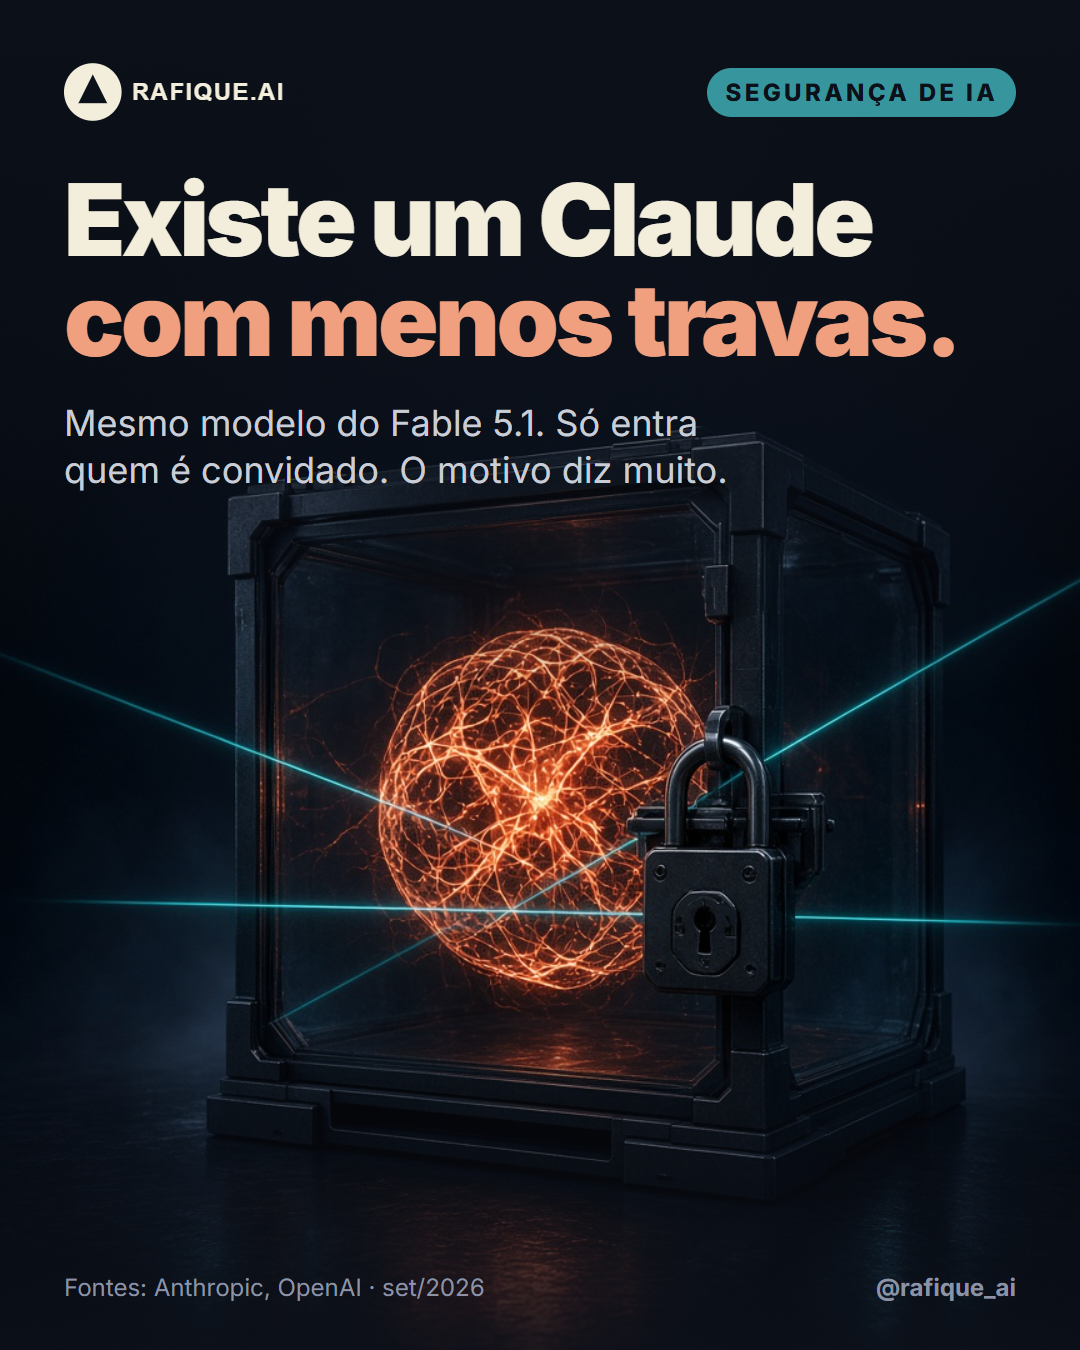
O Claude Opus 5.5 é o modelo de alto nível mais barato da Anthropic, e a empresa diz que ele entrega o nível do Fable 5.1 na maior parte do trabalho. Mas o lançamento teve um segundo capítulo, menos comentado: é também a primeira vez que um modelo Opus sai com salvaguardas da mesma classe do Fable 5.1 em cibersegurança, biologia e destilação.
O motivo está no anúncio oficial da Anthropic: "Como o Opus 5.5 é comparável ao Claude Mythos 5.1 em biologia e cibersegurança, estamos colocando nele salvaguardas semelhantes às do Claude Fable 5.1." E o Opus 5.5 é o primeiro lançamento desde que a Anthropic pediu publicamente para cadenciar a fronteira ("pacing the frontier").
Este artigo explica o que isso quer dizer na prática, como fica o acesso para quem trabalha nessas áreas e por que a escolha de modelo está virando também uma escolha de política.
A família e onde o Opus 5.5 se encaixa
| Modelo | Papel na linha da Anthropic | Acesso |
|---|---|---|
| Claude Fable 5.1 | Topo da linha, com o conjunto mais rígido de salvaguardas | Disponível para todos (API, app, nuvens) |
| Claude Mythos 5.1 | Os mesmos pesos do Fable 5.1; biologia mais permissiva via LSVP; cyber via CVP só no futuro próximo | Invite only (Project Glasswing); hoje, só organizações dos EUA. O Claude Security (Enterprise) já usa o Mythos |
| Claude Opus 5.5 | Nível Fable na maioria das tarefas; comparável ao Mythos 5.1 em bio e cyber | Amplo (API, app, nuvens), com salvaguardas tipo Fable e fallback |
| Claude Opus 5 / 4.8 | Geração anterior | Recebem as tarefas quando as salvaguardas do 5.5 intervêm |
O ponto que costuma confundir: o Opus 5.5 não é o modelo mais capaz da Anthropic em tudo, mas chega perto do topo na maioria das tarefas — e, em biologia, iguala ou supera o Mythos 5.1 (o Fable 5.1 com menos travas) em muitas áreas. Num teste de longo prazo sobre previsão e design molecular, feito com a Dyno Therapeutics, red-teamers especialistas avaliaram a novidade científica do modelo como comparável à do melhor modelo que já tinham testado.
Um modelo com esse nível em áreas de uso duplo não pode sair com as mesmas regras de um modelo de uso geral comum. Daí as travas.
Fable e Mythos: o mesmo modelo, travas diferentes
Existe, sim, um Claude com menos travas — e ele não é um modelo mais forte escondido. A frase da arte, "mesmo modelo do Fable 5.1", está certa. O anúncio de 1º de setembro diz com todas as letras: "Claude Fable 5.1 e Claude Mythos 5.1 são o mesmo modelo, mas com níveis diferentes de salvaguardas." O Fable está disponível para todos; o Mythos, só pelos programas de acesso confiável.
O system card vai um passo além: as duas versões são configurações do mesmo modelo, com pesos idênticos. O que muda é a trava.
- Fable 5.1: acesso geral, com salvaguardas extras que bloqueiam tarefas de alto risco em biologia e cibersegurança.
- Mythos 5.1: relaxa parte dessas travas só para quem é verificado. Em ciências da vida, isso já vale pelo Life Sciences Verification Program (as demais salvaguardas continuam). Em cibersegurança, o Cyber Verification Program deve incluir a classe Mythos "no futuro próximo" — ainda não é o caminho aberto hoje.
- Claude Security: o produto que varre bases de código e sugere correções para revisão humana já está disponível para clientes Claude Enterprise e roda com o Mythos 5.1.
- Como se pede acesso: a documentação marca o Mythos como invite only, lançado em 1º de setembro de 2026, dentro do Project Glasswing. Por enquanto, só um grupo de organizações dos Estados Unidos. A Anthropic diz que coordena com o governo americano para abrir a parceiros nacionais e internacionais "o mais rápido possível".
É essa lógica que o Opus 5.5 herda. Como ele é comparável ao Mythos 5.1 em biologia e cibersegurança, sai com as salvaguardas do Fable 5.1: o mesmo "degrau" de trava vale para qualquer modelo que chegue a esse nível de capacidade, e o acesso sem trava passa a depender de verificação, não do modelo que você escolhe.
O modelo de acesso restrito também tem um custo político. Segundo o Financial Times (repercutido por ITPro, TNW e eWeek em 9 e 10 de setembro), a Anthropic não deu ao AI Security Institute do Reino Unido acesso ao Mythos 5.1 antes do lançamento — a primeira vez que o instituto ficou de fora da avaliação pré-lançamento de um modelo da Anthropic, depois de ter testado o Mythos 5 em abril. A empresa não explicou publicamente o motivo; o governo britânico disse que o AISI "continua colaborando de perto" com a Anthropic.
Como as travas funcionam na prática
- Cibersegurança: você pode encontrar e corrigir bugs no seu código normalmente, como parte do ciclo de desenvolvimento. Mas a maior parte das tarefas de cibersegurança é redirecionada para o Claude Opus 4.8.
- Biologia: o Opus 5.5 usa as mesmas salvaguardas de biologia do Fable 5.1, com um classificador de biologia além do de cyber. Tarefas de biologia e de desenvolvimento de LLMs de fronteira que acionam a salvaguarda vão para o Opus 5.
- Destilação: o modelo sai com o preserved thinking, que impede usuários da API de editar o contexto anterior para extrair o raciocínio do Claude. Vale para contas criadas a partir de 31/08/2026.
- Tudo com fallback transparente: quando a salvaguarda intervém, outro modelo responde. Na API, uma recusa volta com
stop_reason: "refusal"e a área da política.
A Anthropic admite o custo disso: os benchmarks do lançamento foram rodados com as salvaguardas ligadas, e quando elas intervieram as tarefas foram resolvidas pelos modelos anteriores — o que provavelmente reduz a nota do Opus 5.5. No AutomationBench, rodado pela Zapier sem fallback, cada intervenção contou como falha.
Acesso verificado para quem trabalha nessas áreas
- Life Sciences Verification Program (aberto): organizações verificadas — laboratórios acadêmicos, startups, farmacêuticas — podem se inscrever para usar o Opus 5.5 com salvaguardas desenhadas para toda a amplitude do trabalho em biologia.
- Cyber Verification Program (expansão nas próximas semanas): profissionais de cibersegurança verificados poderão usar o Opus 5.5 no trabalho. O programa terá três níveis de acesso cada vez mais permissivos, incluindo acesso a modelos Claude Mythos.
- Claude Security: já disponível com acesso ao Claude Mythos 5.1.
Para a maioria das empresas, nada disso trava o dia a dia: desenvolvimento, análise, documentos, atendimento e automação seguem normais. O impacto aparece para quem faz pentest, pesquisa de vulnerabilidade, bioinformática ou P&D em ciências da vida — esses times precisam planejar a verificação antes de migrar.
O que é o "pacing" de Dario Amodei
Na semana anterior ao lançamento, o CEO da Anthropic, Dario Amodei, defendeu que o progresso da IA seja cadenciado para que as práticas de segurança fiquem à frente da capacidade dos modelos (o texto se chama "We Must Pace the Frontier"). A Anthropic apresenta o pacing como uma forma de manter a IA segura, continuar competitiva com a China e colher os benefícios da IA, principalmente em biologia e medicina.
O argumento tem duas camadas:
- Para os modelos atuais, a Anthropic diz que o conjunto de práticas existente é adequado: testes extensos de alinhamento, avaliação externa antes do lançamento (METR e Frontier Design testaram o Opus 5.5) e salvaguardas proporcionais à capacidade em áreas de alto risco.
- Para os próximos — modelos capazes de automatizar totalmente o próprio trabalho de pesquisa em IA — ela diz que será preciso um padrão de segurança ainda mais alto, que essas medidas sozinhas talvez não atendam, e que políticas públicas devem ter papel maior. O pedido de pacing se baseia em boa parte na expectativa de que esses modelos possam ser treinados em breve.
No lado do comportamento, o Opus 5.5 teve as melhores notas de qualquer modelo da Anthropic na auditoria comportamental automatizada (quase 2.000 cenários), é o modelo mais forte da casa na maioria das medidas de honestidade e tentou contornar barreiras de contenção cerca de 85% menos que o Opus 5 ou o Mythos 5.1.
E do outro lado: o GPT-6 Astra
A comparação com a OpenAI ajuda a entender o momento. Na página de segurança do GPT-6 Astra, a própria OpenAI afirma que ele é o primeiro modelo dela a atingir o nível Critical de capacidade em cibersegurança no seu Preparedness Framework — capaz, com as ferramentas e o acesso certos, de encontrar falhas de segurança desconhecidas e desenvolver formas de explorá-las em sistemas bem protegidos sem uma pessoa guiando cada passo. Em biologia e química, o Astra ficou no nível High.
A OpenAI lançou o Astra de forma ampla, com salvaguardas reforçadas e o programa Trusted Access for Cyber atualizado.
| Anthropic — Claude Opus 5.5 | OpenAI — GPT-6 Astra | |
|---|---|---|
| Classificação de risco divulgada | Comparável ao Mythos 5.1 em bio e cyber; salvaguardas de nível Fable 5.1 | Primeiro modelo da OpenAI no nível Critical de cibersegurança no Preparedness Framework; High em biologia e química |
| O que acontece em tarefa sensível | Fallback transparente: cyber → Opus 4.8; bio e desenvolvimento de LLMs de fronteira → Opus 5 | Salvaguardas reforçadas em toda a stack |
| Acesso para profissionais | Life Sciences Verification Program (aberto) e Cyber Verification Program (em expansão, três níveis) | Trusted Access for Cyber (atualizado para o Astra) |
| Discurso público | "Pacing": segurança deve andar na frente da capacidade | Lançamento amplo com salvaguardas proporcionais ao risco |
Fontes: anúncio do Opus 5.5 (Anthropic) e página de Deployment Safety do GPT-6 Astra (OpenAI).
Repare que, na prática, os dois laboratórios estão convergindo: modelos de ponta chegam com travas por área e com acesso verificado para profissionais. A diferença maior está no discurso — a Anthropic pedindo publicamente para cadenciar a fronteira, a OpenAI publicando o nível de risco e lançando com mitigação. Mais contexto sobre o Astra no nosso guia do GPT-6 Astra.
O que isso muda para a sua empresa
- Escolha de modelo virou escolha de política. Além de preço e benchmark, pergunte: o que esse modelo recusa, para qual modelo ele cai quando recusa e o que isso faz com a qualidade da minha tarefa?
- Trate recusas como parte do fluxo. Na API do Opus 5.5, a recusa vem com HTTP 200 e
stop_reason: "refusal". Se o seu sistema não lê isso, ele vai tratar uma recusa como resposta válida (veja o guia de migração da API). - Times de segurança e ciências da vida: inscrevam-se nos programas de verificação antes de depender do modelo em produção.
- Dados e conformidade: o Opus 5.5 está disponível com retenção zero de dados e vem com marca d'água para cumprir o AI Act europeu — pontos que contam em contratos com clientes regulados.
- Agentes autônomos: as mesmas travas que limitam uso indevido protegem você quando o agente roda sozinho — classificador por ação, sandbox auditável e baixa taxa de prompt injection (detalhes em agentes de 18 horas).
A pergunta que fica, e que vale a discussão no seu time: você prefere IA mais rápida ou IA mais cadenciada? Para a maior parte das empresas, a resposta prática é "a que eu consigo auditar".
Fontes
- Anthropic — Introducing Claude Opus 5.5 (22/09/2026)
- Anthropic — Claude Fable 5.1 e Claude Mythos 5.1 (01/09/2026)
- Anthropic — System card do Claude Fable 5.1 e do Claude Mythos 5.1 (pesos idênticos; LSVP agora, CVP no futuro próximo)
- Claude Platform Docs — Claude Mythos 5.1 (invite only, Project Glasswing, 01/09/2026)
- Claude Platform Docs — What's new in Claude Opus 5.5
- OpenAI — GPT-6 Astra Deployment Safety / System Card
- ITPro — Anthropic reportedly withholds access to Mythos 5.1 from UK safety testing body (09/09/2026)
- eWeek — Anthropic Withholds Claude Mythos 5.1 From UK Testing (10/09/2026)
- Rafique AI — GPT-6 Astra: não é só mais um ChatGPT
IA de ponta com governança, não com susto
A Rafique AI mapeia risco, recusas e fallback dos modelos no seu fluxo e desenha a adoção com dono, limite e evidência.