NOVIDADE DE IA · 23/09/2026
Jev, da TypeSafe AI: o que é a IA que não escreve nada (e só decide)
O Jev não é chatbot nem agente: você manda um texto e perguntas fechadas, e ele devolve sim/não, uma escolha ou uma nota, com a probabilidade junto. Custa $0,042 por milhão de tokens de entrada e a saída é grátis. O que é, quem fez, quanto custa de verdade e onde ele falha.
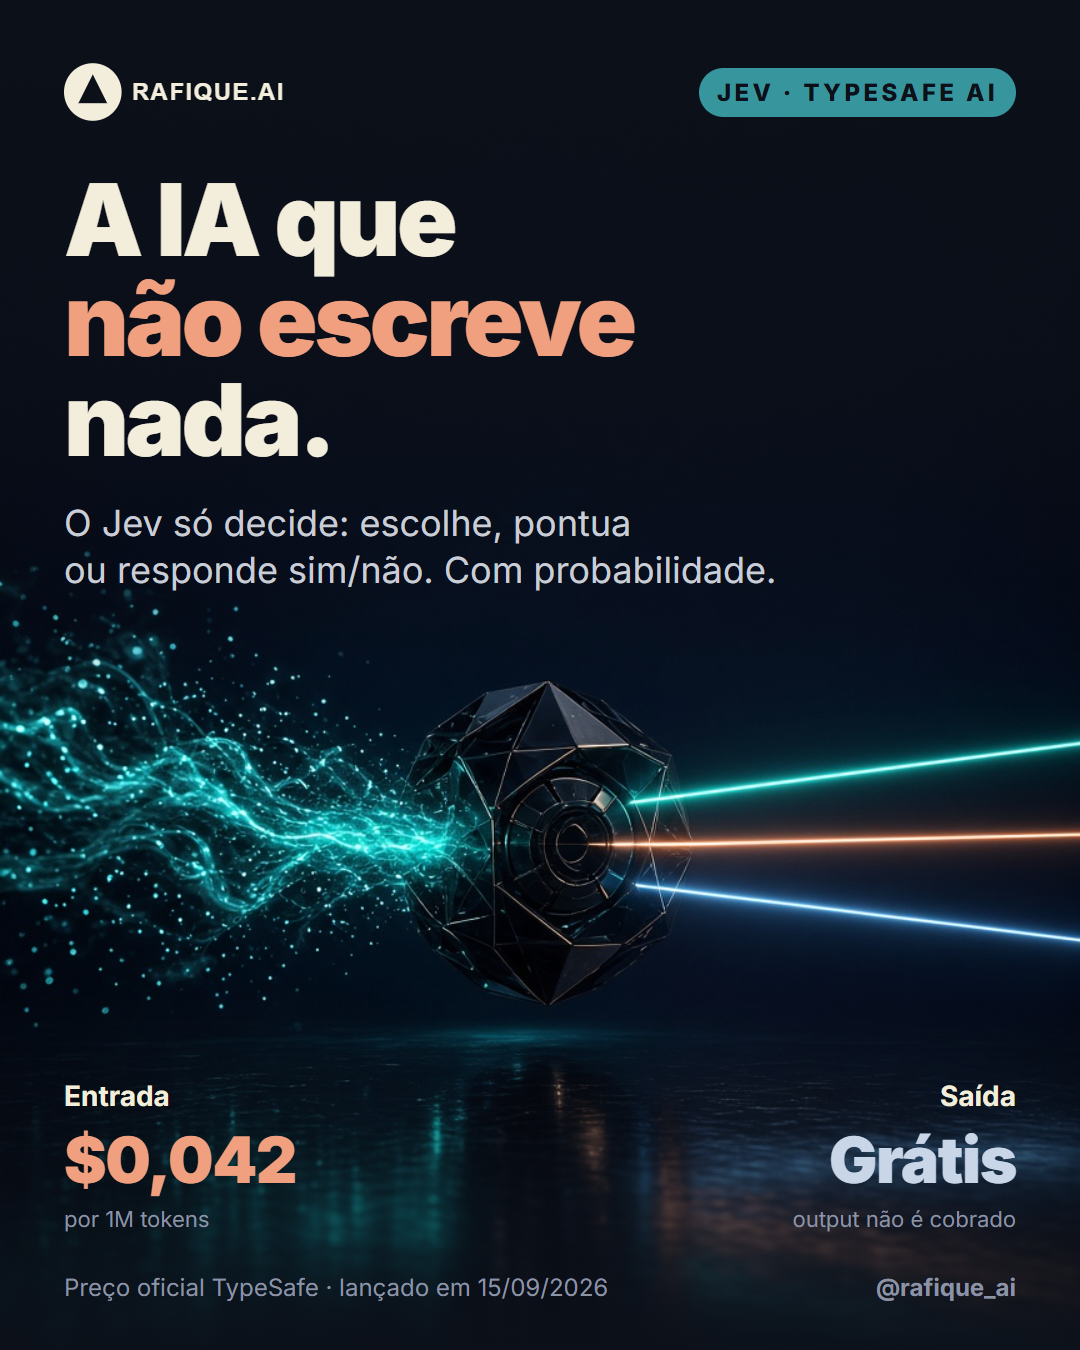
Em 15 de setembro de 2026 a TypeSafe AI lançou o Jev, e em poucos dias ele virou o assunto da semana entre desenvolvedores. O motivo é curioso: o Jev não escreve uma linha de texto. Não é chatbot, não é "mais um agente" e não compete com o Claude ou o GPT na redação.
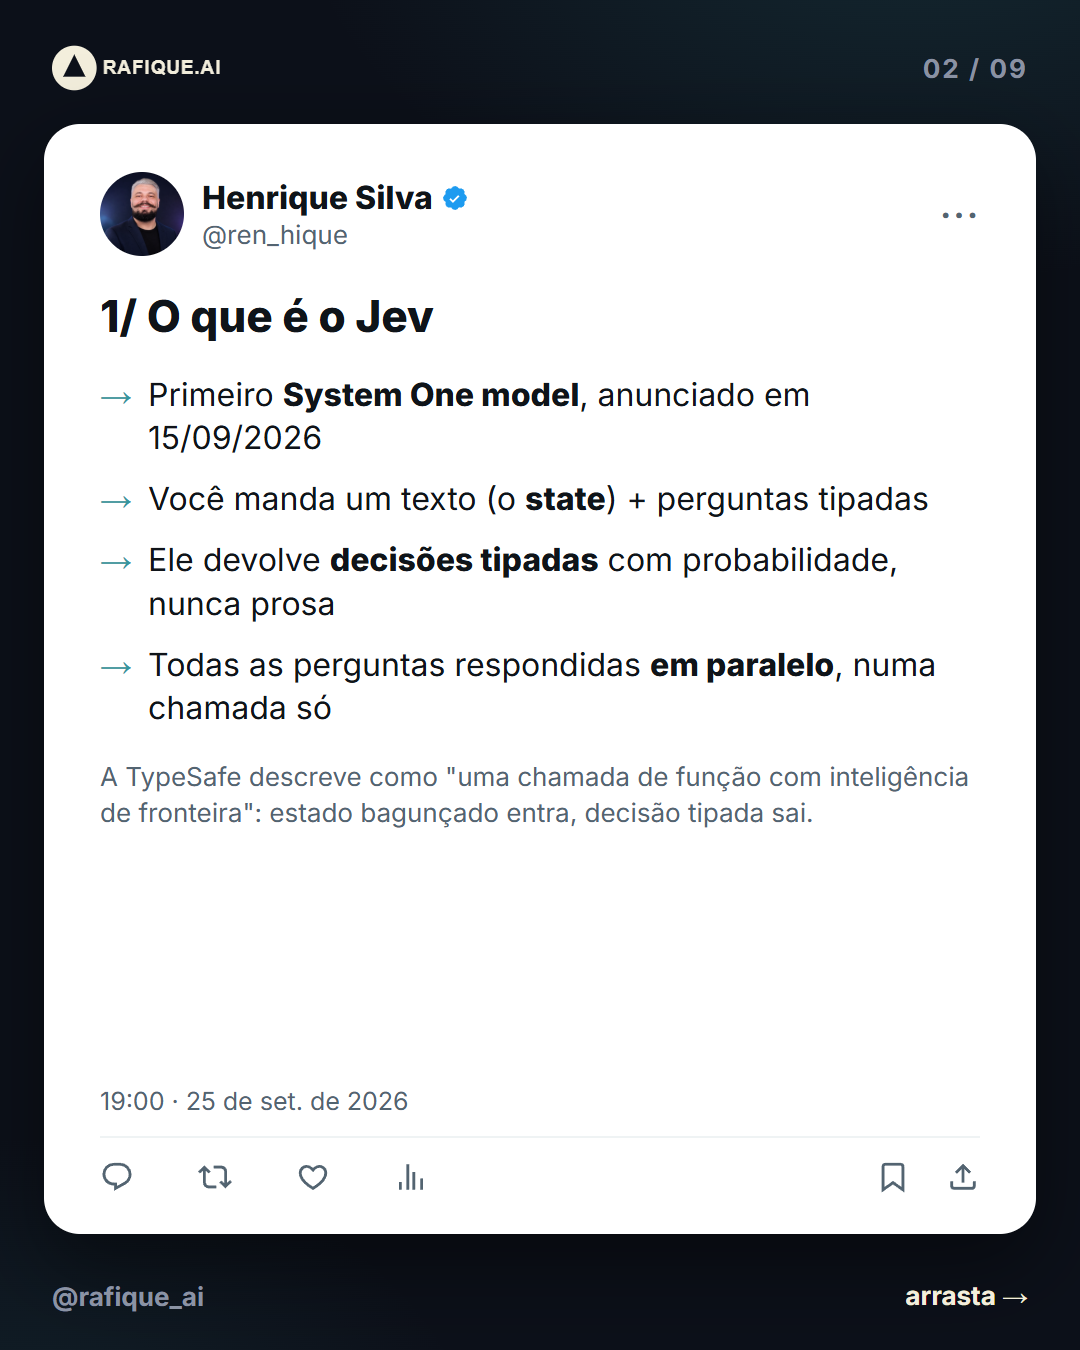
Ele faz uma coisa só: decide. Você manda um texto (o state) e perguntas fechadas; ele devolve a resposta tipada — sim/não, uma escolha ou uma nota — com a probabilidade junto. Quem decide o próximo passo é o seu código.
Este guia explica o que é o Jev, quem fez, quanto custa de verdade, o que ainda é só promessa da própria empresa e os pontos fracos que a TypeSafe mesma publicou. Para o lado mão na massa, leia depois o Jev na prática; para a letra miúda dos números, Jev: hype vs realidade.
Um modelo "System One": decidir rápido, não deliberar em prosa
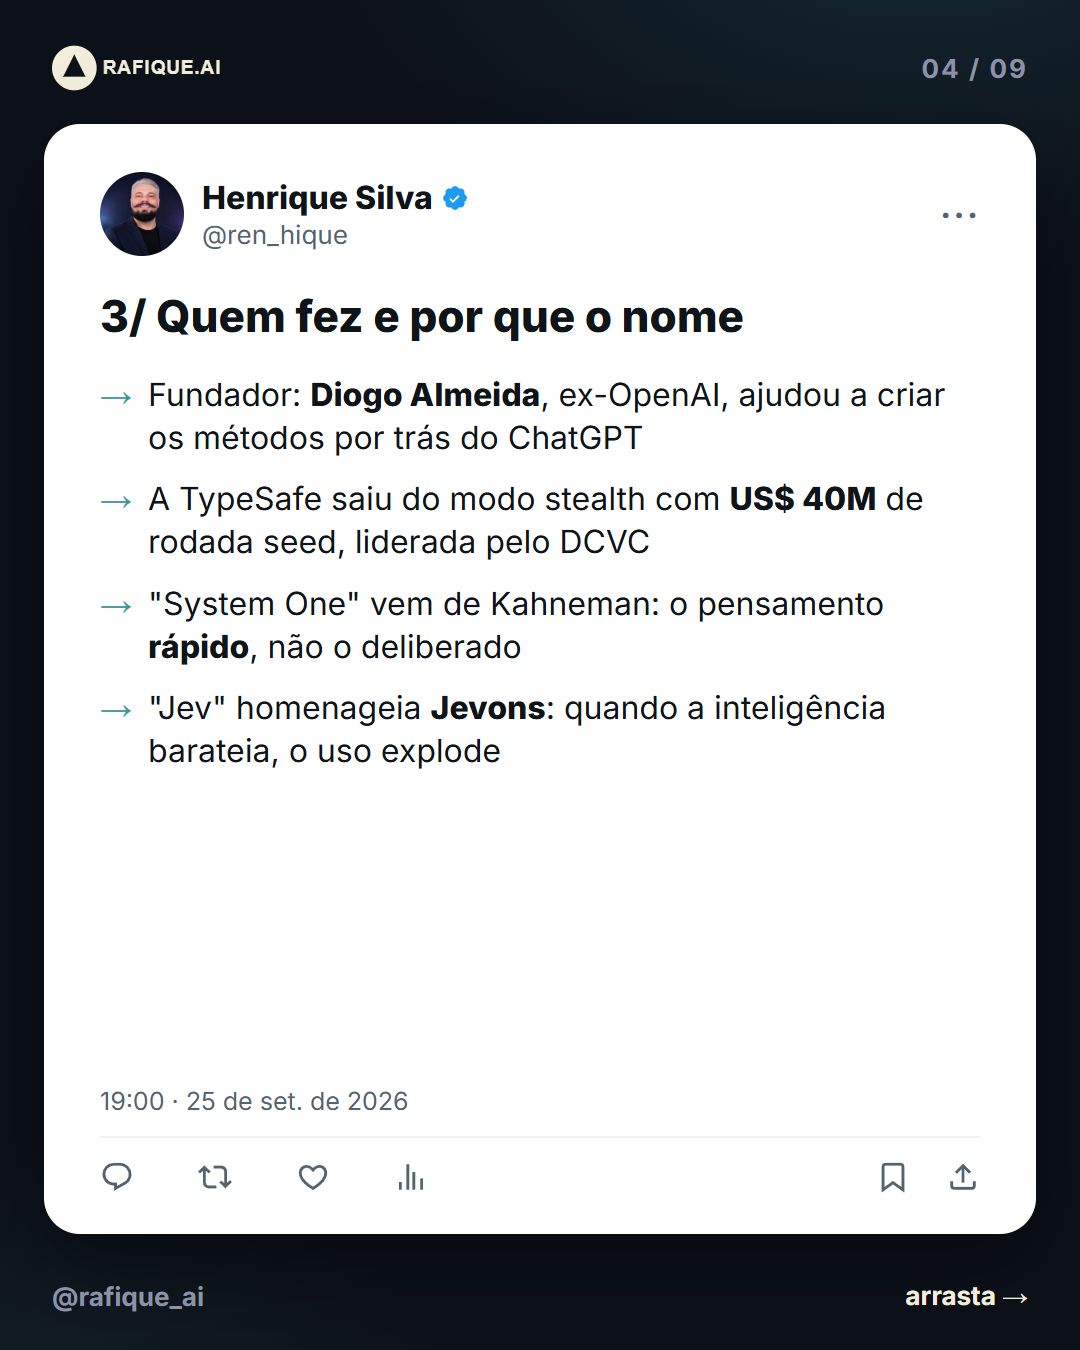
A TypeSafe chama o Jev de primeiro modelo System One. A referência é ao psicólogo Daniel Kahneman, que dividiu o pensamento em Sistema 1 (rápido, intuitivo) e Sistema 2 (lento, deliberado). LLMs como Claude e GPT fazem o papel do Sistema 2: raciocinam em texto, token a token. O Jev fica com o Sistema 1: julgamentos rápidos e estruturados.
O nome homenageia William Stanley Jevons, o economista do paradoxo de Jevons — quando um recurso fica muito mais barato de usar, o consumo total tende a subir. A aposta explícita da TypeSafe é essa: decisão barata o bastante para você colocá-la em todo lugar do sistema.
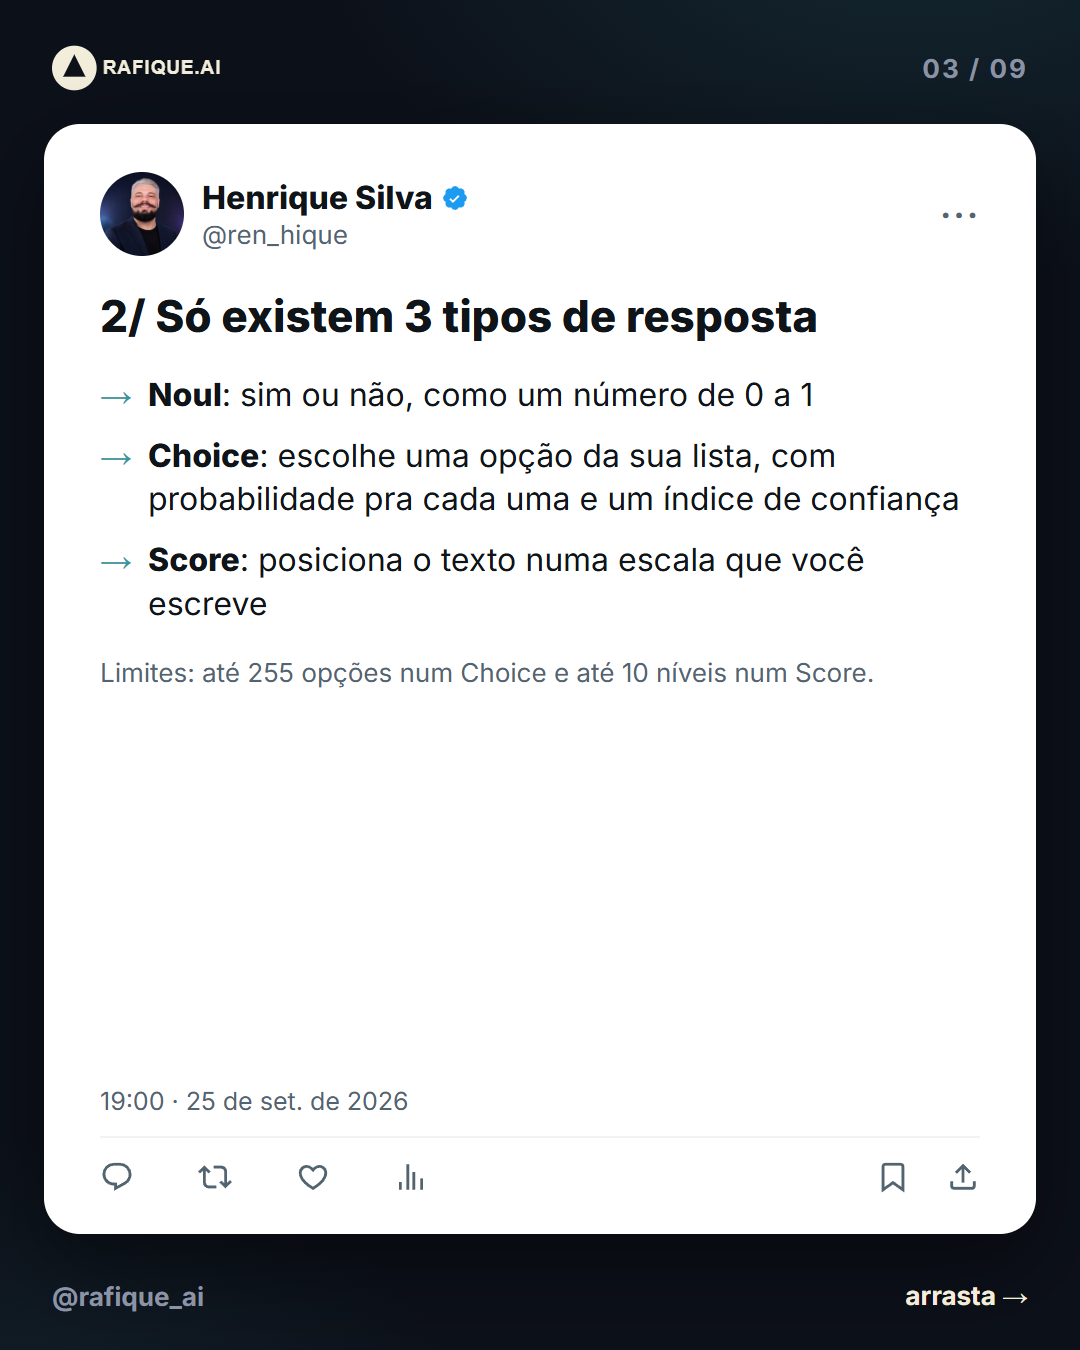
Na prática, cada pergunta tem um de três tipos:
| Tipo de pergunta | O que devolve | Exemplo |
|---|---|---|
| Noul | Probabilidade de um enunciado ser verdadeiro (um sim/não com número) | "A mensagem transmite urgência?" |
| Choice | Uma opção entre as que você definiu, com probabilidade por opção e confiança | "Qual fila: técnico, cobrança ou vendas?" |
| Score | Posição numa escala que você define (degraus descritos em texto), também com confiança | "Frustração: calmo / frustrado mas educado / muito irritado" |
Fonte: post de lançamento e documentação da TypeSafe AI.
Você pode mandar várias perguntas na mesma chamada, sobre o mesmo state. Como a saída não é cobrada, perguntar mais coisas custa quase nada a mais.
Quem fez e como foi treinado
A TypeSafe AI foi fundada por Diogo Almeida, que o post de lançamento descreve como ex-OpenAI e parte da pesquisa por trás do ChatGPT. Segundo o systemonemodels.org, os cofundadores são Erik Gafni (CTO) e Sasha Sheng (COO), e a empresa levantou uma rodada seed de US$ 40 milhões liderada pela DCVC.
O modelo foi treinado com uma técnica que a empresa chama de RLCD (Reinforcement Learning for Calibrated Decisions, aprendizado por reforço para decisões calibradas) — ou seja, o foco do treino é que a probabilidade devolvida seja confiável, não só a resposta. A TypeSafe não publicou pesos, arquitetura nem dados de treino — então qualquer comparação técnica mais profunda ainda depende do que a própria empresa diz.
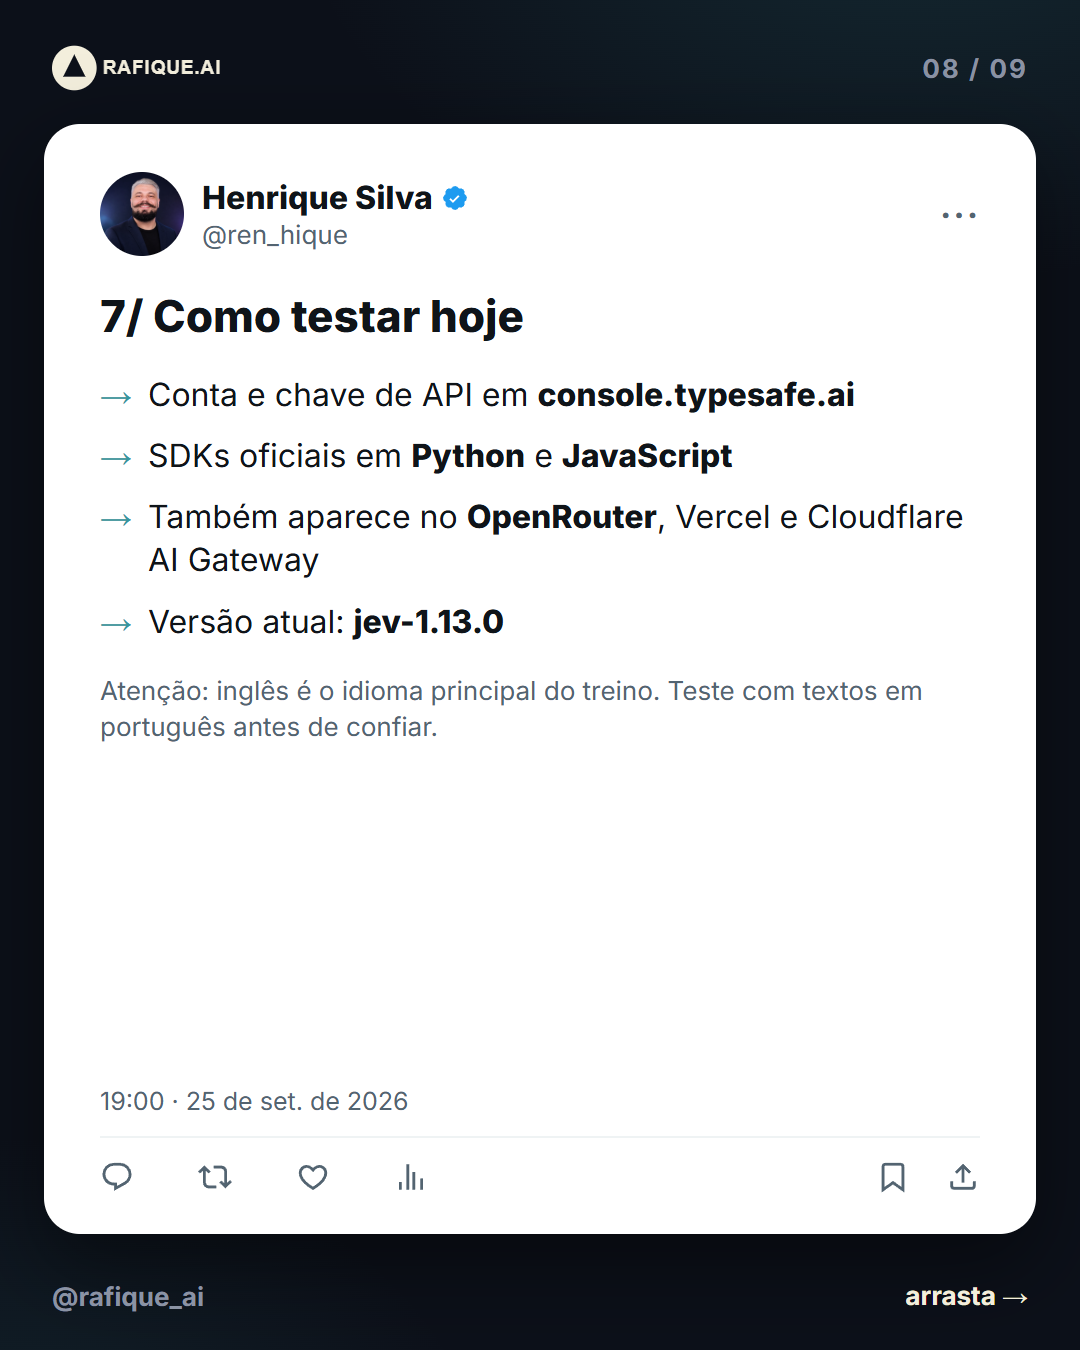
O lançamento foi em acesso antecipado: a TypeSafe disse que estava tirando desenvolvedores da fila "o mais rápido possível". Hoje o caminho é criar uma conta em console.typesafe.ai, gerar uma chave de API e testar no Playground.
Quanto custa de verdade
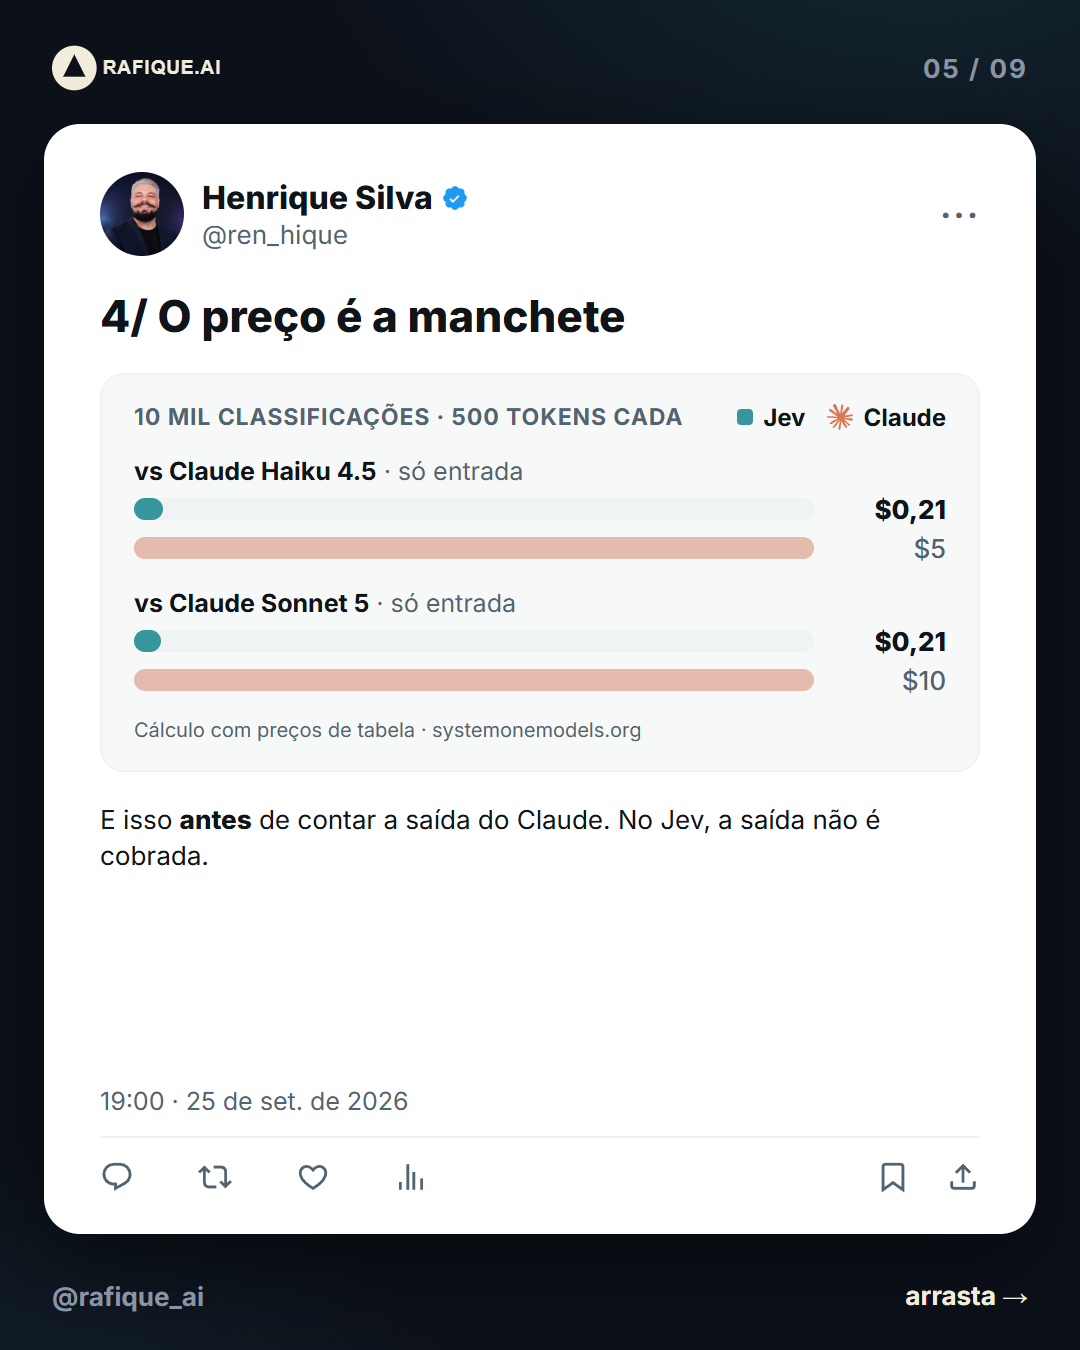
O preço é o que chama atenção: $0,042 por milhão de tokens de entrada, e a saída não é cobrada. Para comparar com LLMs, o systemonemodels.org fez uma conta simples com 10 mil classificações de 500 tokens cada:
| 10 mil classificações × 500 tokens de entrada | Custo de entrada |
|---|---|
| Jev ($0,042 / 1M) | $0,21 |
| Claude Haiku 4.5 | $5 |
| Claude Sonnet 5 | $10 |
| Claude Opus 5 | $25 |
Conta do systemonemodels.org, só com tokens de entrada. Na vida real o LLM ainda cobra a saída (e o raciocínio); o Jev não cobra saída.
Duas ressalvas honestas. Primeiro, a conta só considera entrada; um LLM ainda cobra a resposta e, em modelos que raciocinam, os tokens de pensamento — o que aumenta a diferença a favor do Jev. Segundo, a própria TypeSafe admite no post de lançamento que não tem como provar que o preço não é subsidiado. Preço de lançamento pode mudar.
Velocidade: promessa forte, número da própria empresa
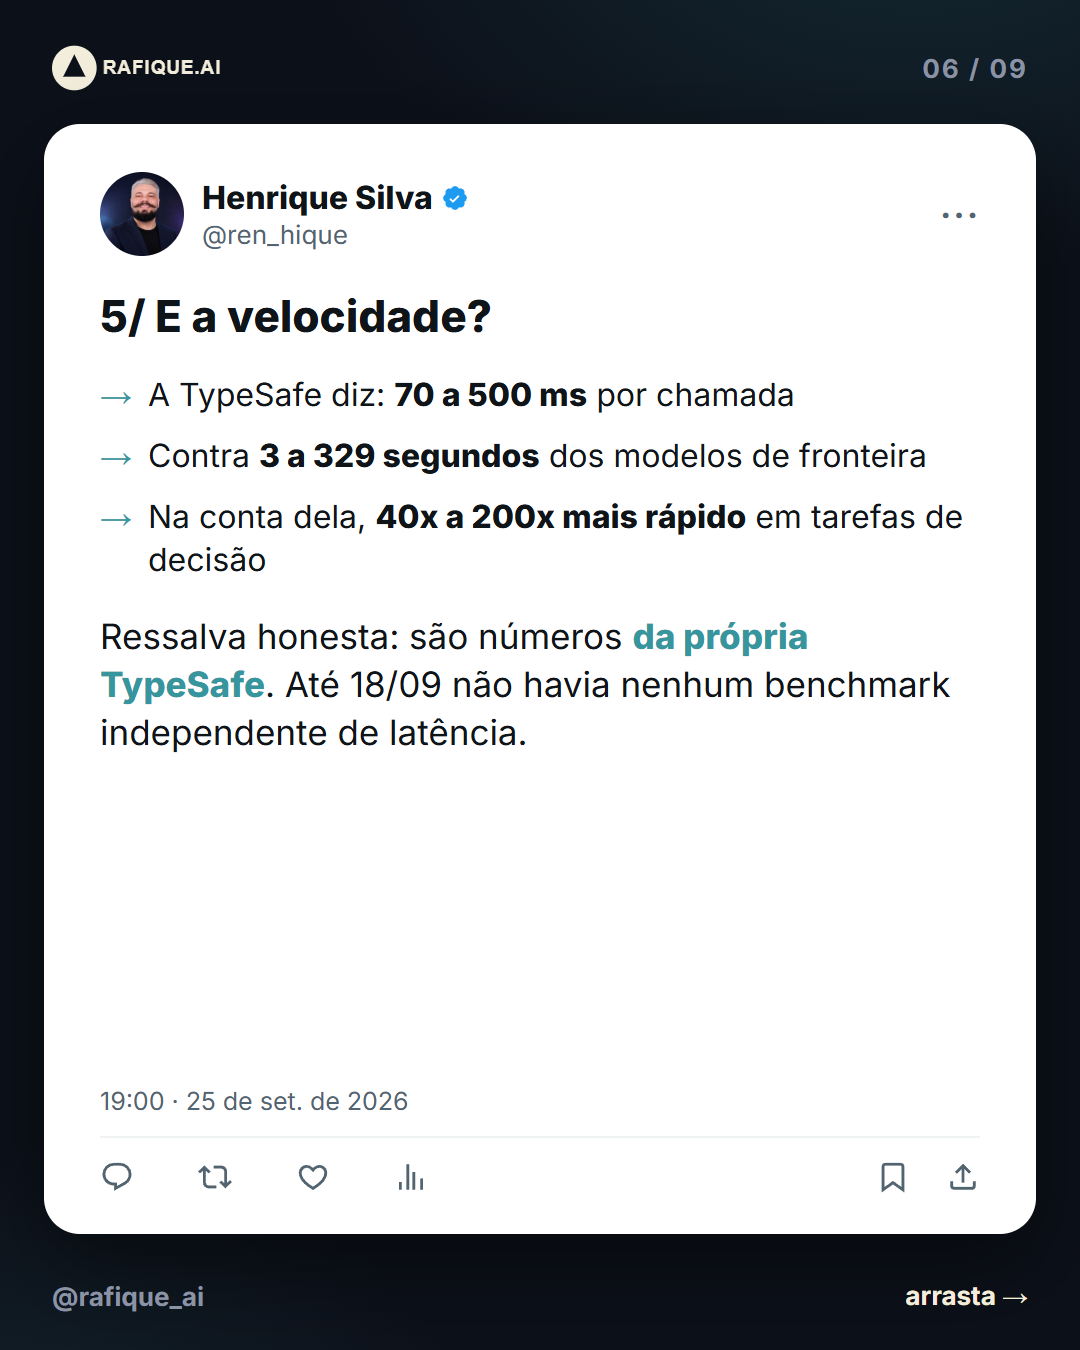
A TypeSafe diz que o Jev responde em 70 a 500 ms, contra 3 a 329 segundos de LLMs de ponta nos mesmos fluxos — algo entre 40x e 200x mais rápido. Na página inicial, a manchete é "193,6x mais rápido e 444,6x mais barato".
Esses números vêm de quatro fluxos criados pelo próprio time, comparados com a média do GPT-6 Astra e do Claude Fable 5.1, e a empresa diz esperar que fiquem "no topo" dos ganhos do mundo real. As medições foram feitas a partir de laptops na costa oeste dos EUA. Até 18 de setembro não havia benchmark independente de velocidade, segundo o systemonemodels.org. Destrinchamos isso em Jev: hype vs realidade.
Ficha técnica e limites
| Item | Jev 1.13 |
|---|---|
| Versão atual | jev-1.13.0 (aliases jev-latest e jev-preview apontam para ela) |
| Preço | $0,042 por 1M tokens de entrada; saída grátis |
| Contexto | 64k tokens por request; 32k para o state + a pergunta mais longa |
| Entrada | Só texto; inglês é o idioma principal |
| Choice | Até 255 opções por pergunta |
| Limites | 250 mil tokens/s e 1.200 requisições/min, ajustados dinamicamente |
| Dados | Não treina com dados de clientes; ZDR (retenção zero) para enterprise |
| Pesos | Não publicados (nem arquitetura nem dados de treino) |
Fontes: docs.typesafe.ai/models, post de lançamento e systemonemodels.org.
Dois pontos pesam na decisão de adotar. O contexto de 64k (com 32k para o state) é pequeno perto dos LLMs atuais: histórico longo de conversa ou documento grande precisa ser resumido antes. E o inglês é o idioma principal — textos em português funcionam, mas vale medir a qualidade no seu próprio conjunto de exemplos antes de confiar no número de confiança.
Em produção, fixe a versão (jev-1.13.0) em vez de usar o alias: o limiar de confiança que você calibrar vale para aquela distribuição de probabilidade, e muda quando o modelo muda.
Os pontos fracos que a própria TypeSafe publicou
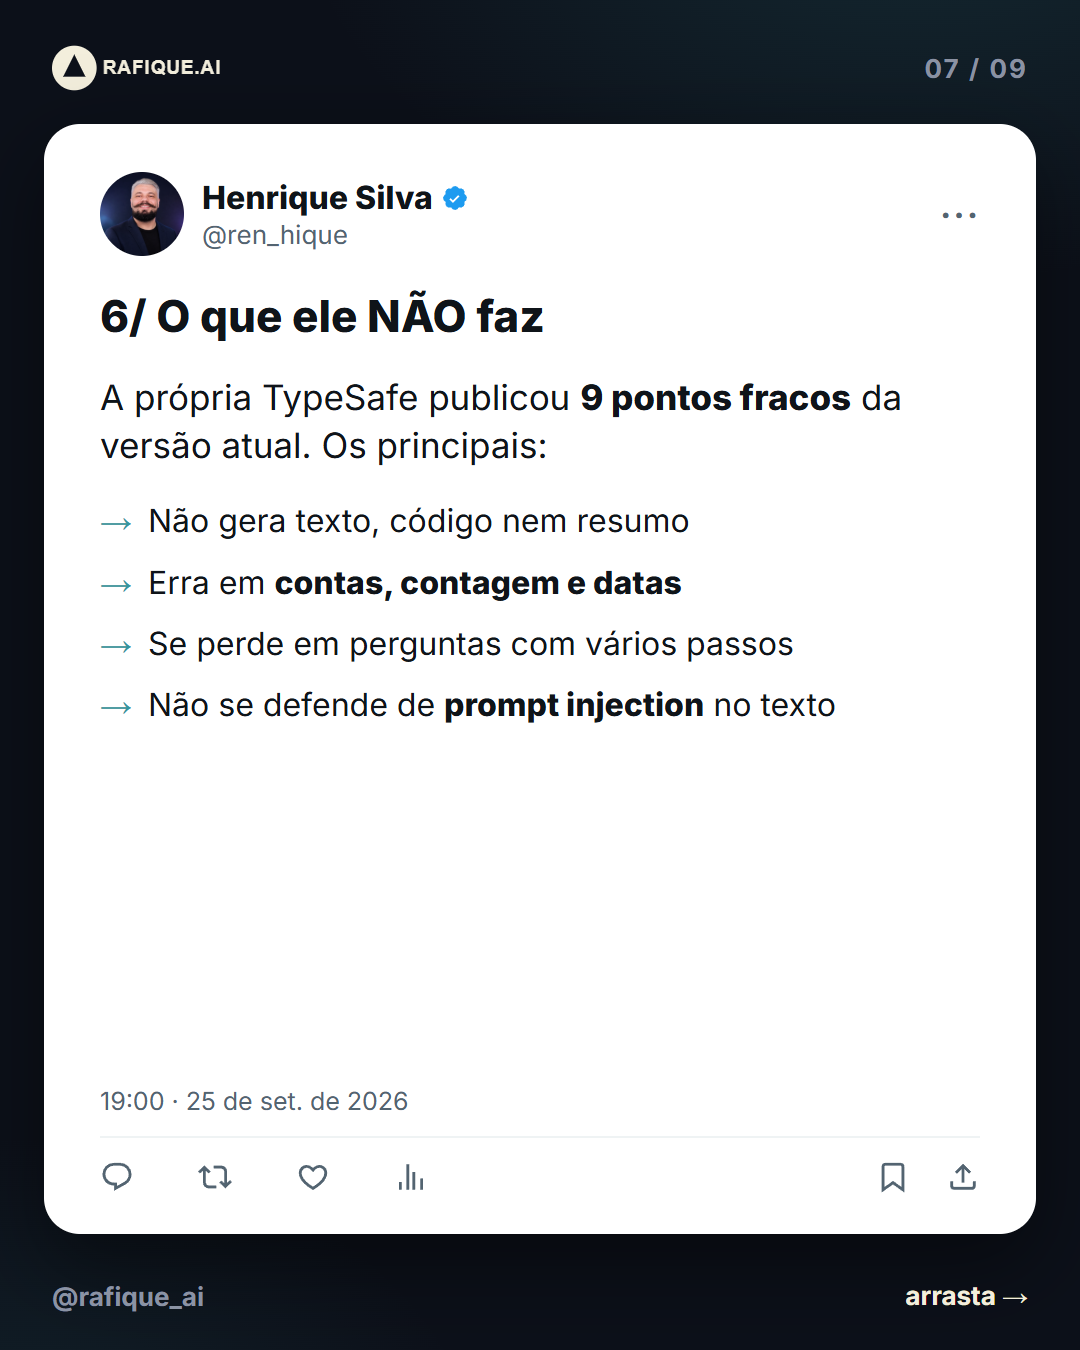
Um mérito raro: a TypeSafe mantém uma página de jaggedness com os tipos de tarefa em que o Jev 1.13 erra. São nove:
- Leitura literal demais do enunciado.
- Matemática, números e contagem.
- Datas.
- Indireção (a resposta depende de algo referido em outro lugar).
- State grande e cheio de coisa irrelevante.
- Conteúdo adversarial (tentativas de manipular a resposta).
- Instruções contraditórias.
- Invariantes estruturais (regras exatas que devem sempre valer).
- Geração — ele não foi feito para produzir texto.
A regra que sai daí: conta, data e regra exata continuam com o código; texto continua com o LLM; o Jev fica com julgamento sobre linguagem.
Como testar hoje
- Playground: crie a conta em console.typesafe.ai e teste perguntas no Playground sem escrever código.
- API: gere a chave no painel (console.typesafe.ai/keys) e chame
POST https://api.typesafe.ai/v1/systemone. SDKs oficiais:typesafe-sdk(Python) e@typesafe-ai/sdk(JavaScript). - Gateways: o Jev também apareceu no OpenRouter (em beta), no Vercel AI Gateway e no Cloudflare AI Gateway — esses listam 32K de contexto.
Comece por uma decisão que você já toma hoje com LLM (triagem, roteamento, sim/não antes de uma ação), compare com traces rotulados e só então troque. O passo a passo está em Jev na prática, e a arquitetura geral em Jev Engineering.
O carrossel completo
Os 9 slides do carrossel "Jev: o que é", publicado nas redes da Rafique AI.
Fontes
- TypeSafe AI — Introducing System One Models and Jev (15/09/2026)
- TypeSafe Docs — Models (jev-1.13.0, preços, limites)
- TypeSafe Docs — Jev 1.13 jaggedness (pontos fracos conhecidos)
- TypeSafe Docs — Quickstart
- systemonemodels.org — Jev explained
- systemonemodels.org — página do modelo Jev
- systemonemodels.org — Jev vs Claude
- systemonemodels.org — Jev speed and pricing
- learnjev.com — linha do tempo de notícias
Quer tirar decisões do LLM sem perder controle?
A Rafique AI desenha a divisão de trabalho (o que o LLM escreve, o que o Jev decide e o que o código executa), mede em traces reais e só coloca em produção com dono, limite e evidência.