NOVIDADE DE IA · 23/09/2026
Jev: hype vs realidade — de onde vêm o "193,6x" e o "não alucina"
A TypeSafe diz que o Jev é 193,6x mais rápido e 444,6x mais barato. Um teste da comunidade achou 72,2% de acerto quando ele dizia ter 90% ou mais de confiança. Os dois números são reais; eles só medem coisas diferentes. Lemos a letra miúda.
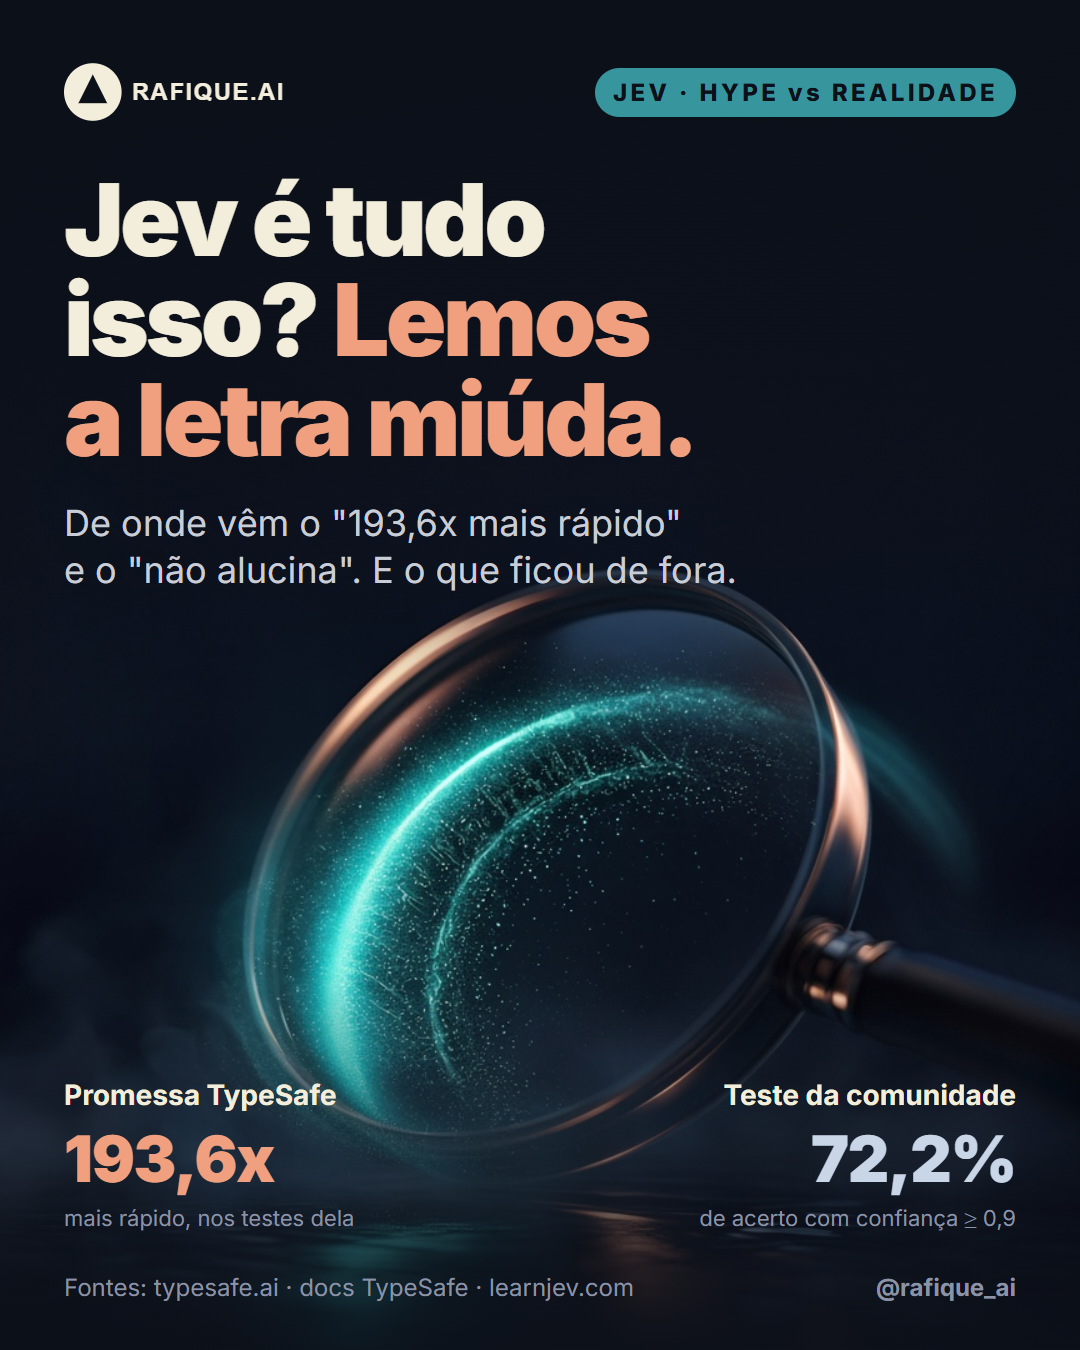
O Jev chegou com números de manchete: 193,6x mais rápido, 444,6x mais barato, "não alucina". A discussão no Hacker News chegou a cerca de 1.900 pontos e 490 comentários — e o título do post foi editado em menos de uma hora para tirar os multiplicadores. Nesta análise, separamos o que é medição, o que é promessa e o que ainda ninguém mediu.
Spoiler: o Jev é útil de verdade para uma classe específica de problema. Mas nenhum número de manchete foi medido de forma independente, e o que a comunidade mediu conta uma história mais modesta. Se você chegou agora, o contexto está em o que é o Jev.
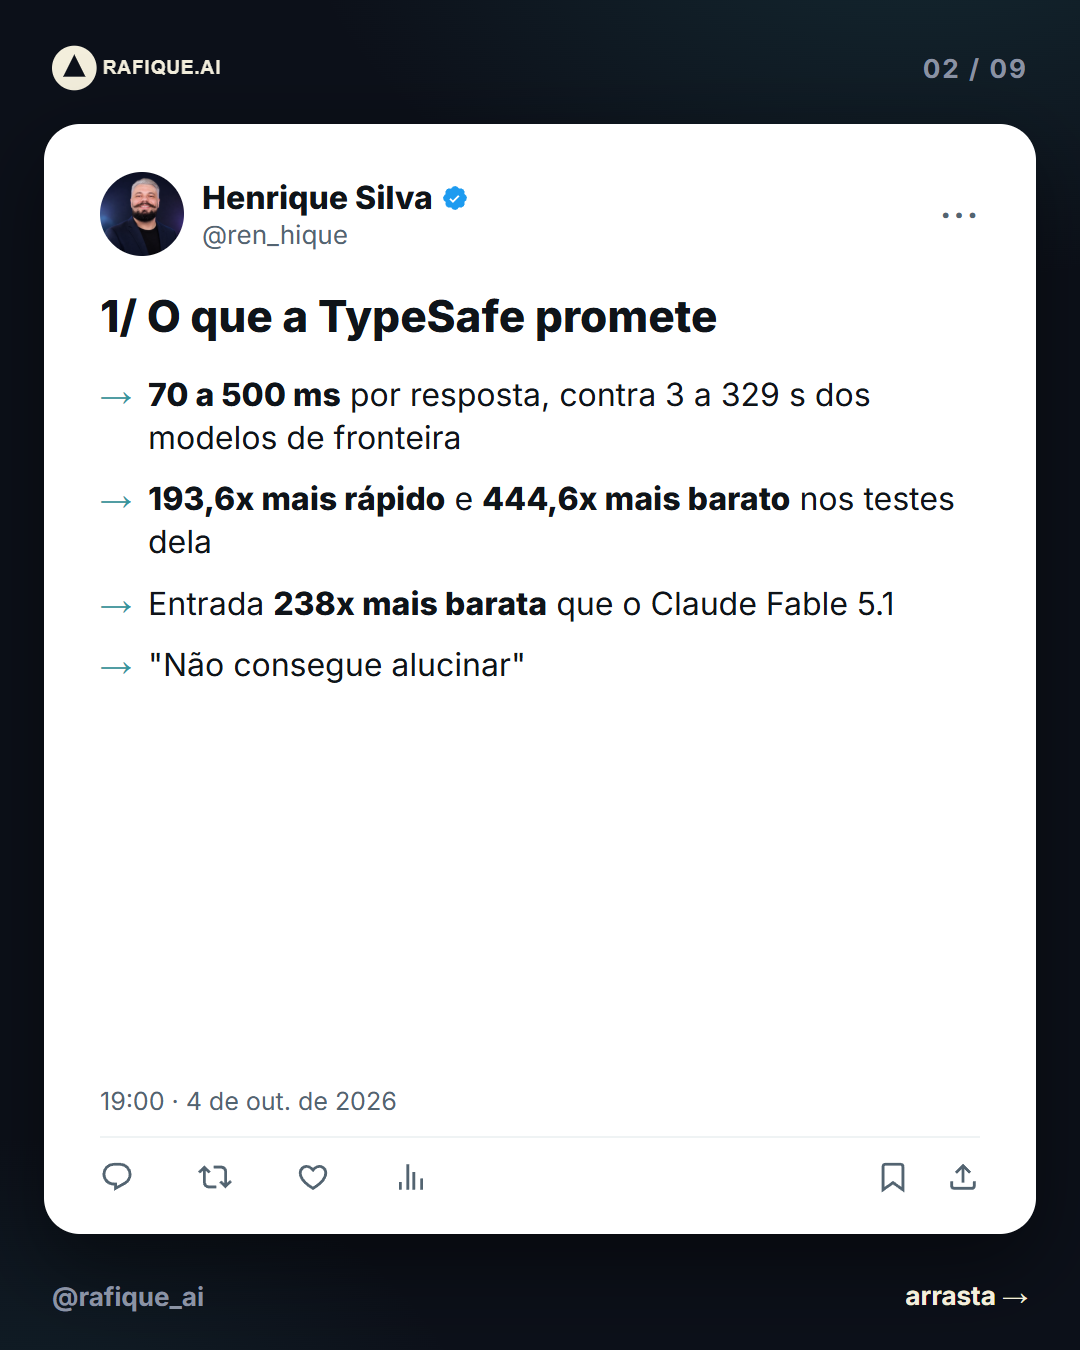
O que a TypeSafe promete, e de onde saem os números
| Promessa | De onde vem | Asterisco |
|---|---|---|
| 193,6x mais rápido | 4 fluxos criados pelo time da TypeSafe | Referência = média do GPT-6 Astra e do Claude Fable 5.1; a empresa diz que o número fica "no topo" dos ganhos reais |
| 444,6x mais barato | Os mesmos 4 fluxos | O preço pode ser subsidiado; a TypeSafe diz que não tem como provar o contrário |
| 238x menor preço de entrada que o Fable 5.1 | Tabela de preços | Compara só entrada |
| 70–500 ms vs 3–329 s | Medido pela TypeSafe, de laptops na costa oeste dos EUA | Sem benchmark independente até 18/09 |
| "Não alucina" | A saída sempre respeita o schema | O 0% é "não empírico": ele pode errar com confiança |
Fontes: typesafe.ai e o post de lançamento de 15/09/2026.
A própria TypeSafe é transparente sobre a origem: os ganhos foram medidos em quatro fluxos que o time construiu, comparando com a média de dois modelos de topo (GPT-6 Astra e Fable 5.1). É uma comparação legítima para mostrar potencial, mas não diz quanto você vai ganhar no seu fluxo — e a empresa mesmo espera que esses números fiquem no alto da faixa real.
Por que "não alucina" tem asterisco
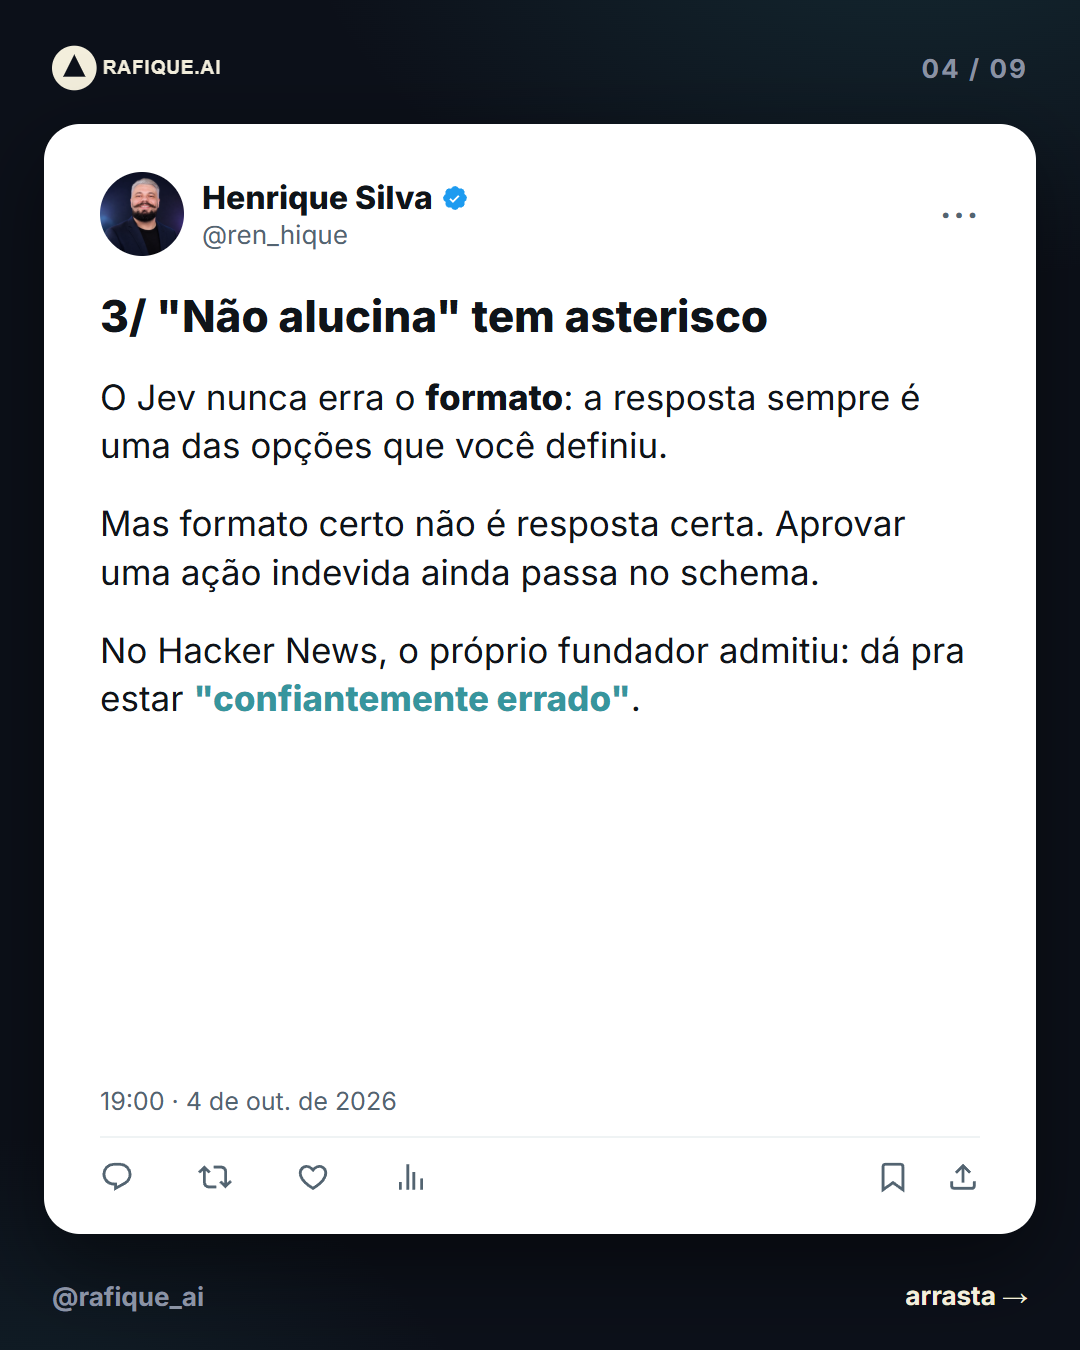
O Jev não gera texto livre, então não consegue inventar um nome de ferramenta que não existe ou uma categoria fora da lista. Nesse sentido estreito, a alucinação de formato é zero — e é por isso que a TypeSafe chama o 0% de "não empírico": é uma garantia do schema, não uma taxa medida.
Mas escolher a opção errada com confiança alta continua possível. O próprio Diogo Almeida, fundador da TypeSafe, reconheceu no Hacker News que é "possível estar confiantemente errado". Para quem desenha o sistema, a pergunta certa não é "ele alucina?", e sim "a confiança dele é confiável?".
Calibração: o que o teste independente achou
Um modelo bem calibrado acerta 90% das vezes em que diz ter 90% de confiança. Um estudo da comunidade com 8.576 respostas achou o seguinte:
- No conjunto CLINC150 (intenções de usuário), o erro de calibração (ECE) foi 0,0204 — bom.
- No Banking77 (intenções bancárias, mais parecidas entre si), o ECE subiu para 0,0936 — bem pior.
- Quando o Jev dizia ter confiança ≥ 0,9, acertou 72,2%.
O estudo é da comunidade e não foi reproduzido, e a TypeSafe ainda não publicou uma métrica oficial de calibração. A lição prática: calibre o limiar no seu domínio. Um 0,9 do Jev não quer dizer 90% de acerto no seu caso.
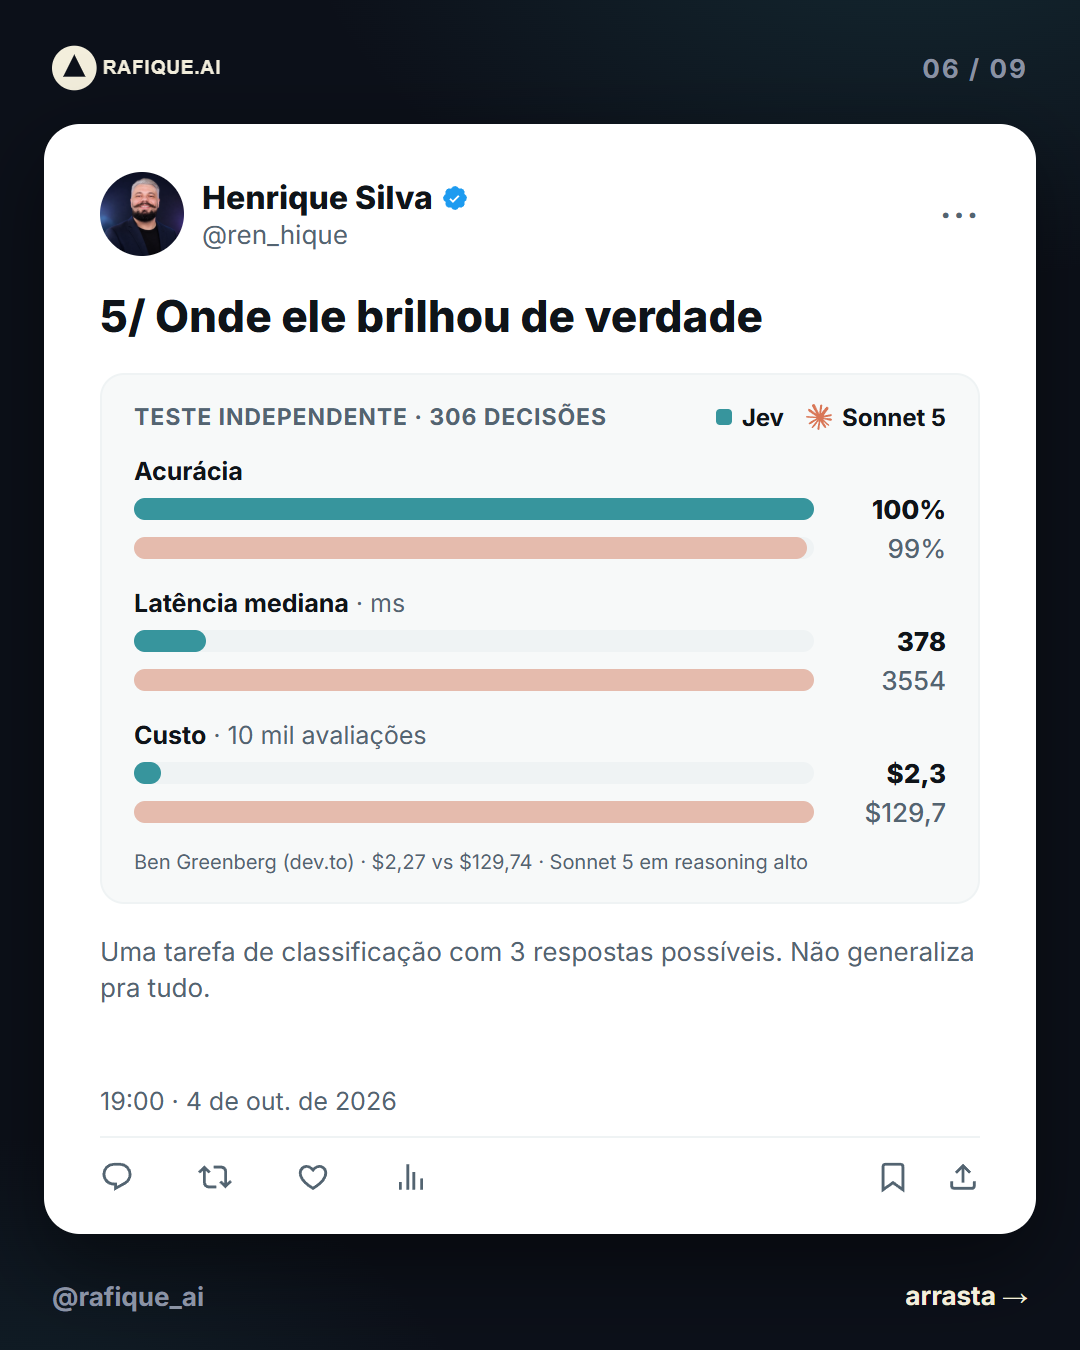
Onde ele brilhou de verdade
| 306 decisões reais | Jev | Claude Sonnet 5 (raciocínio high) |
|---|---|---|
| Acerto | 100% | 99% |
| Latência média | 378 ms | 3.554 ms |
| Custo por 10 mil decisões | $2,27 | $129,74 |
Teste de Ben Greenberg publicado no dev.to, resumido pelo systemonemodels.org.
No teste de Ben Greenberg, com 306 decisões de um fluxo real, o Jev empatou (e passou por pouco) o Claude Sonnet 5 em acerto, com latência quase 10x menor e custo cerca de 57x menor. Esse é o cenário ideal: decisões fechadas, sobre texto, em volume. É uma amostra pequena e de uma pessoa, mas é o tipo de teste que vale replicar no seu fluxo.
Os defeitos que a própria TypeSafe publicou
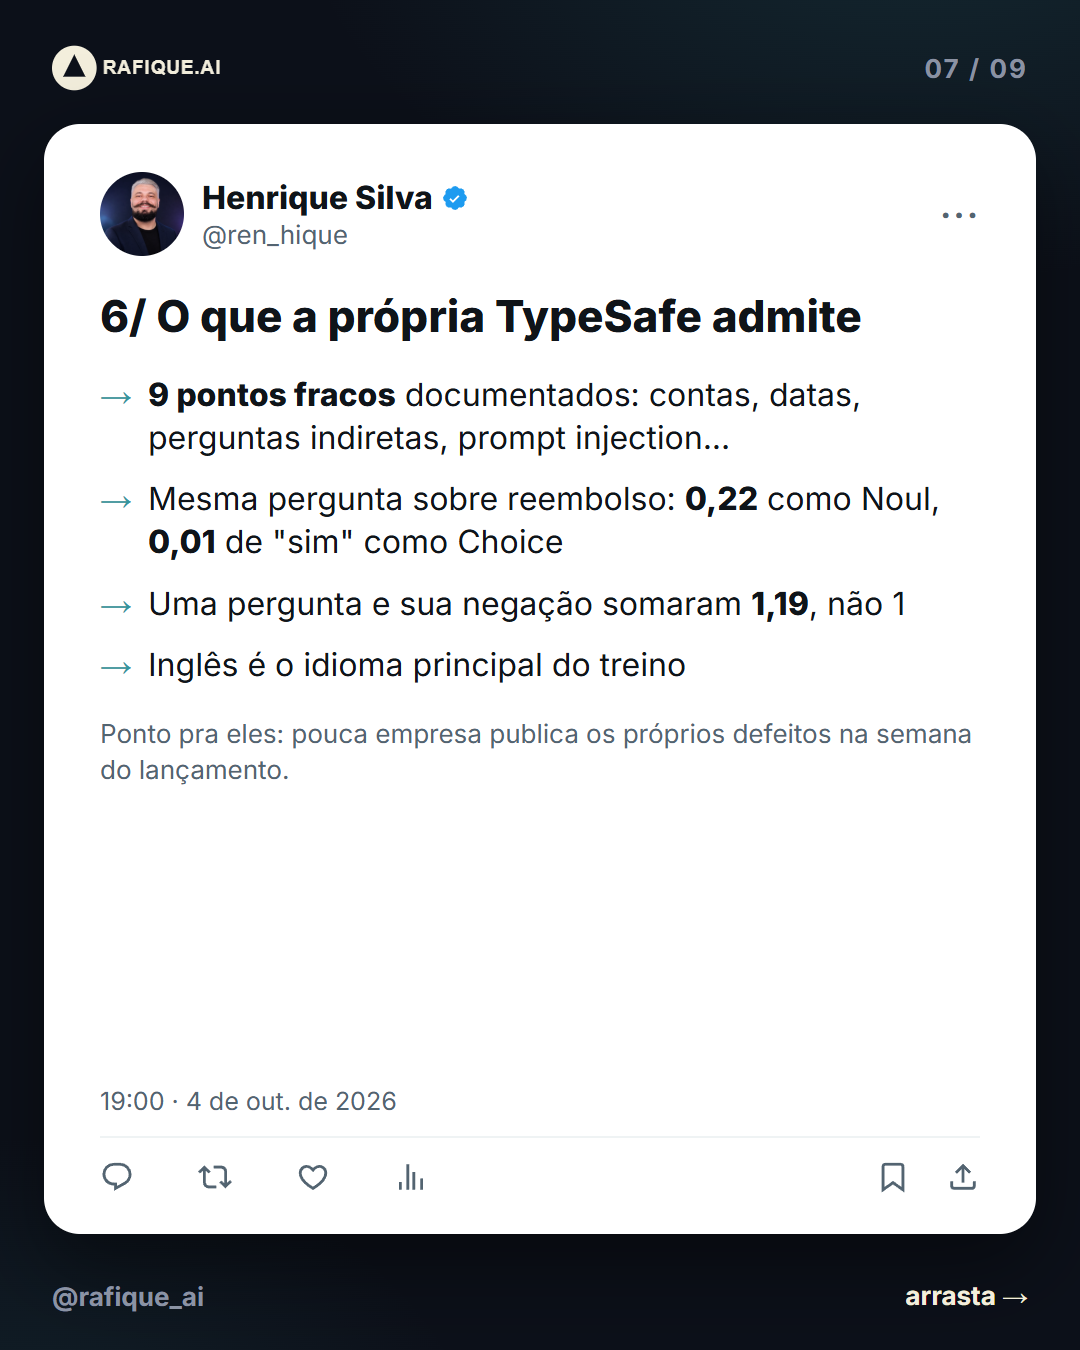
A página de jaggedness do Jev 1.13 lista nove tipos de falha (literalidade, números, datas, indireção, state irrelevante, adversarial, instruções contraditórias, invariantes estruturais e geração) e traz exemplos que merecem atenção:
- Tipos de pergunta discordam entre si. No ticket "não gostei do caimento, quais são as minhas opções?", a pergunta "o cliente está pedindo reembolso?" deu 0,22 como Noul; como Choice sim/não, deu "sim" 0,01 e "não" 0,99, com confiança 0,97. Por isso a TypeSafe avisa: não reaproveite num Choice um limiar calibrado num Noul.
- Pergunta e negação somam mais que 1. No ticket "fui cobrado duas vezes pelo mesmo pedido", "está pedindo reembolso?" deu 0,72 e "está pedindo algo que não seja reembolso?" deu 0,47 — soma 1,19. Identidades desse tipo têm de ser garantidas no código, não esperadas do modelo.
Publicar isso é um bom sinal de honestidade. E também é um lembrete: o número do Jev é um sinal para o seu código, não uma verdade.
O debate: "é só um BERT?"
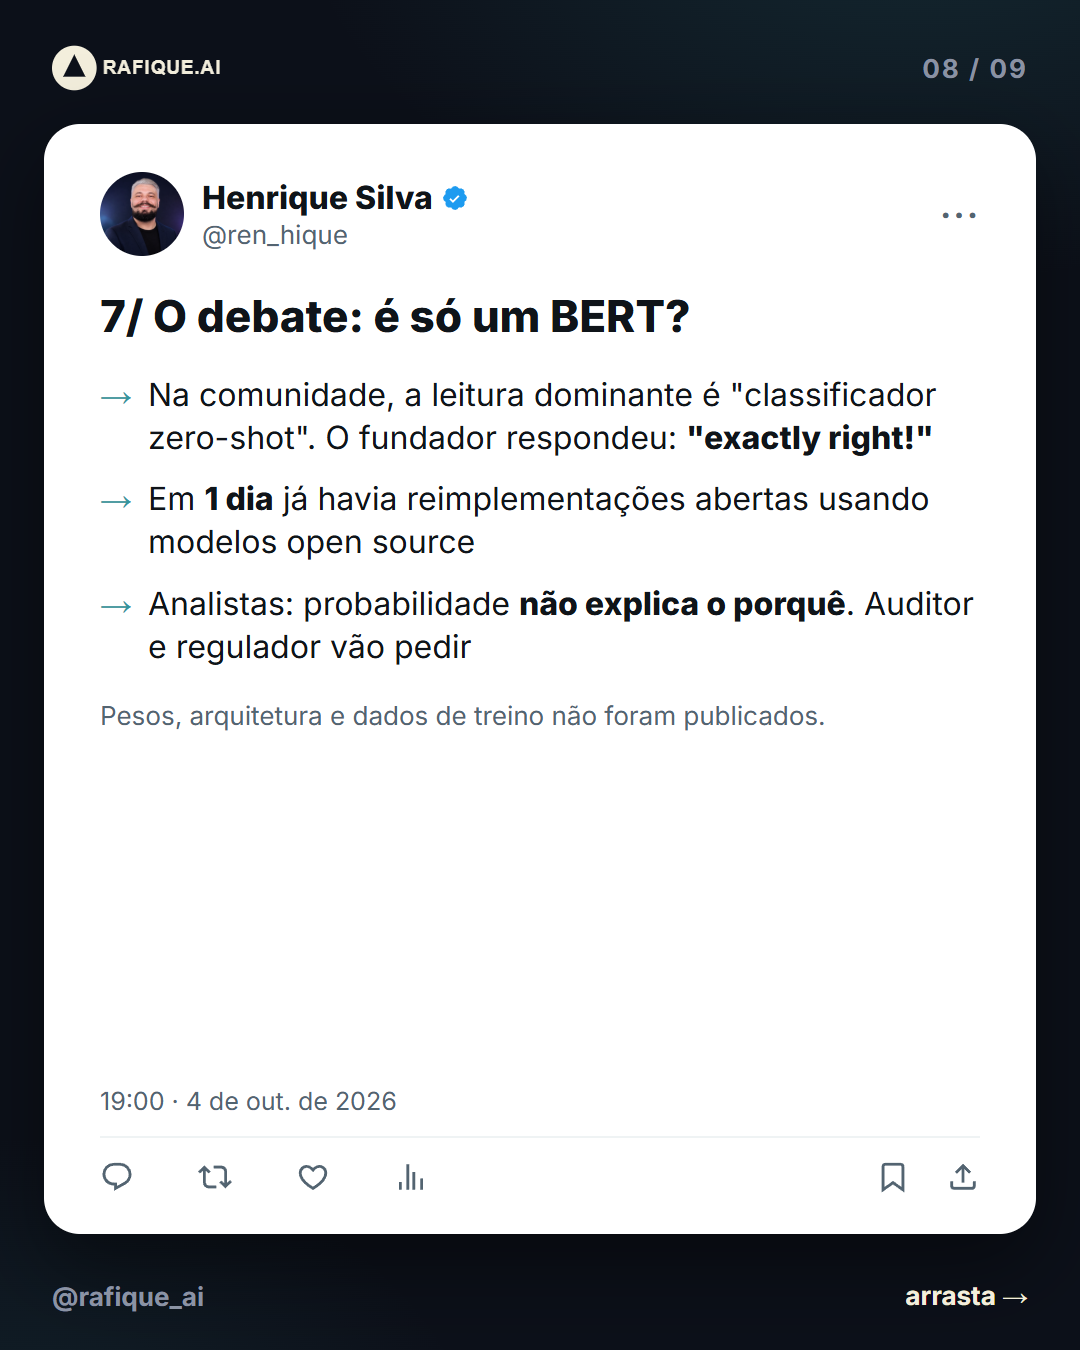
A crítica mais repetida é que o Jev seria um classificador zero-shot sofisticado — algo como um BERT com boa interface. Almeida respondeu "exatamente!" a essa descrição no Hacker News. A graça, segundo a TypeSafe, está em fazer isso sem treinar nada, com qualidade próxima de LLMs de topo, a esse preço e latência.
A comunidade testou a tese rápido: em 16 de setembro, um dia depois do lançamento, já havia reimplementações abertas (uma delas, OpenJev, virou SemIf em 18/09). Os analistas apontaram dois custos que o dev sente logo. Stephanie Walter (HyperFrame Research): é preciso definir de antemão perguntas, saídas possíveis, limiares e caminhos de escalonamento, "o que pode ser uma tarefa significativa". Paul Chada (Doozer AI): uma probabilidade mostra quão confiante o modelo estava, mas "não explica por que" decidiu assim — o que pesa quando é preciso justificar uma decisão automática a um auditor ou regulador. Sem pesos, arquitetura ou dados publicados, a comparação técnica segue em aberto.
Veredito
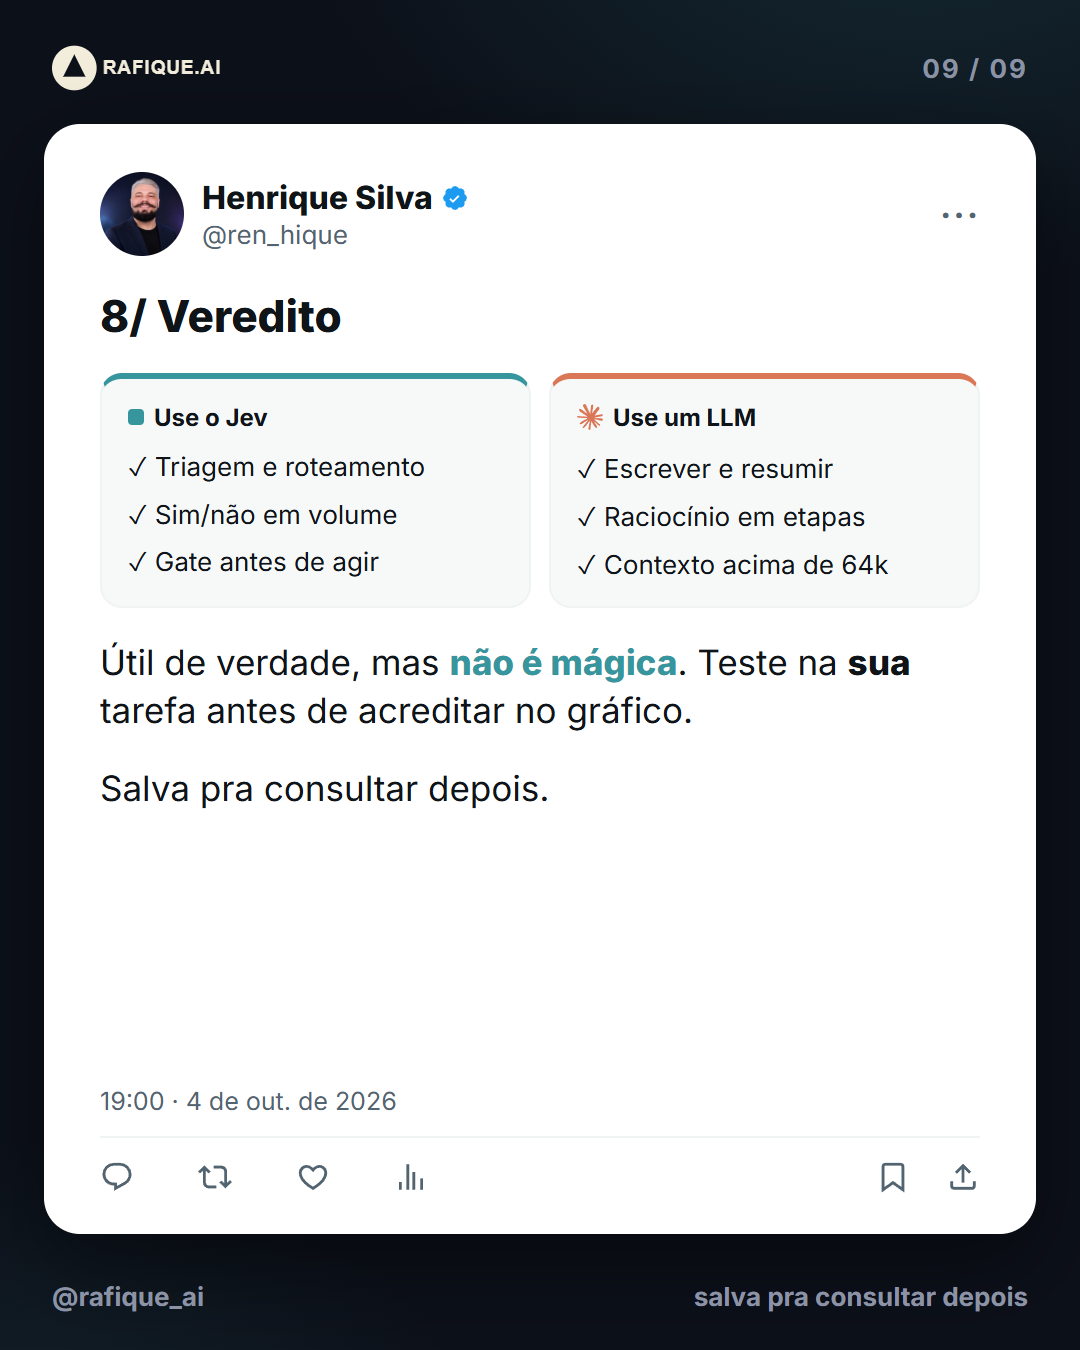
| Use o Jev quando… | Fique com LLM ou código quando… |
|---|---|
| A decisão é sobre linguagem e tem opções fechadas | A tarefa exige conta, data ou regra exata |
| O volume é alto e a latência importa | O contexto passa de 64k tokens |
| Você tem traces rotulados para calibrar o limiar | Você precisa de uma explicação em prosa do porquê |
| Existe fallback para respostas incertas | O conteúdo pode ser adversarial e não há outra camada de defesa |
Útil, mas não é mágica. O Jev é uma ferramenta boa para decisões fechadas sobre linguagem, em volume e com fallback. Os números de manchete são da própria empresa; o que vale é o teste no seu fluxo. Como montar esse teste está em Jev na prática.
O carrossel completo
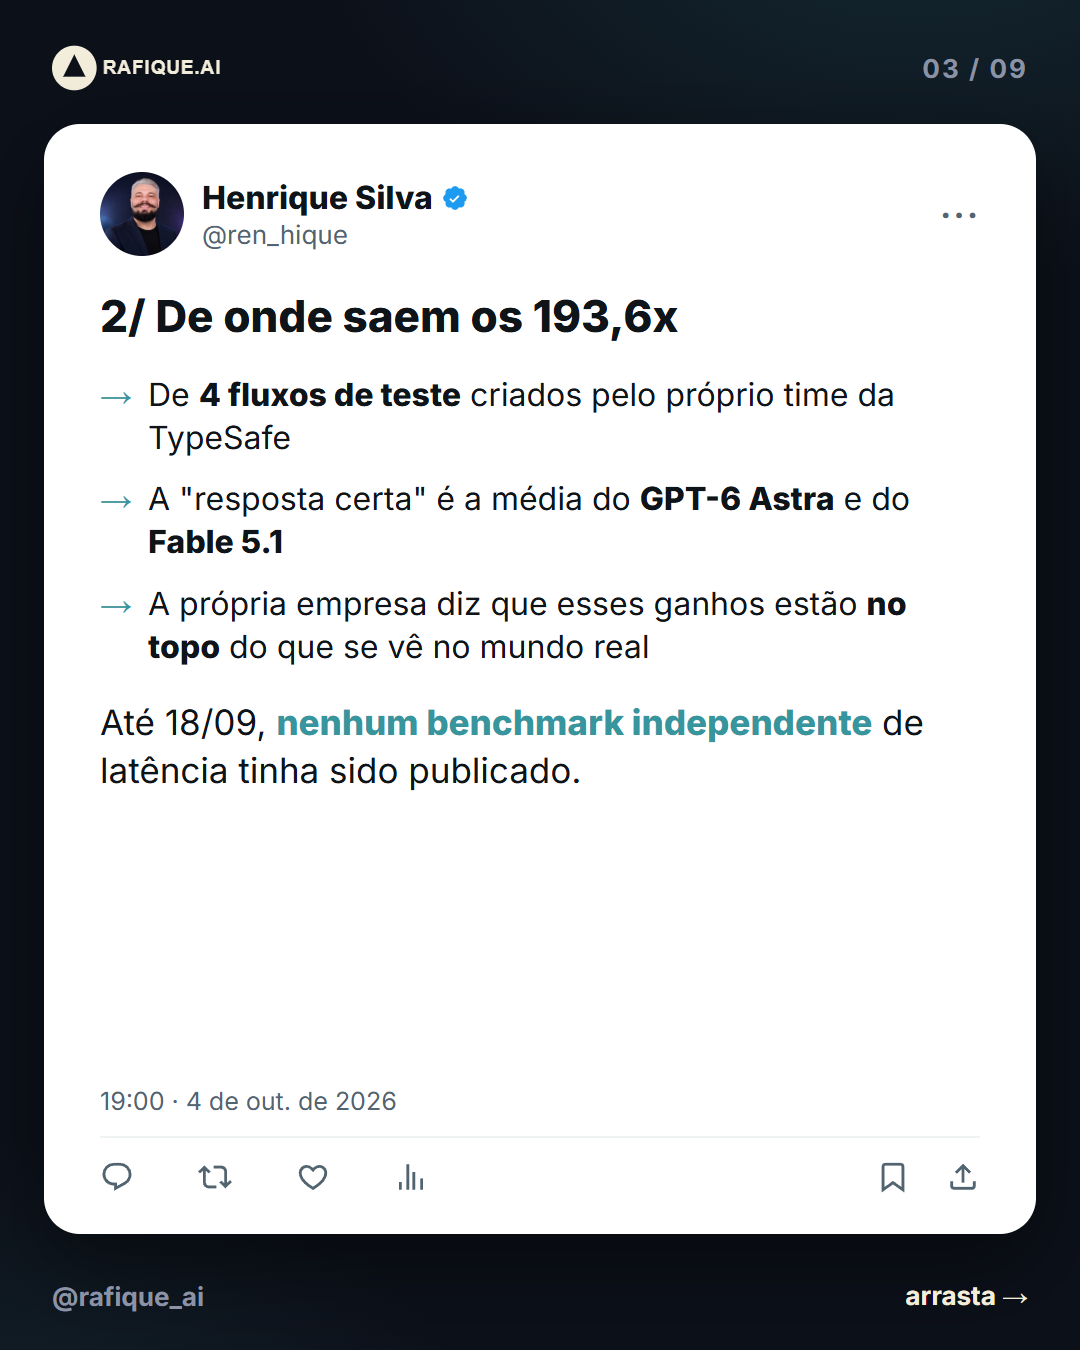
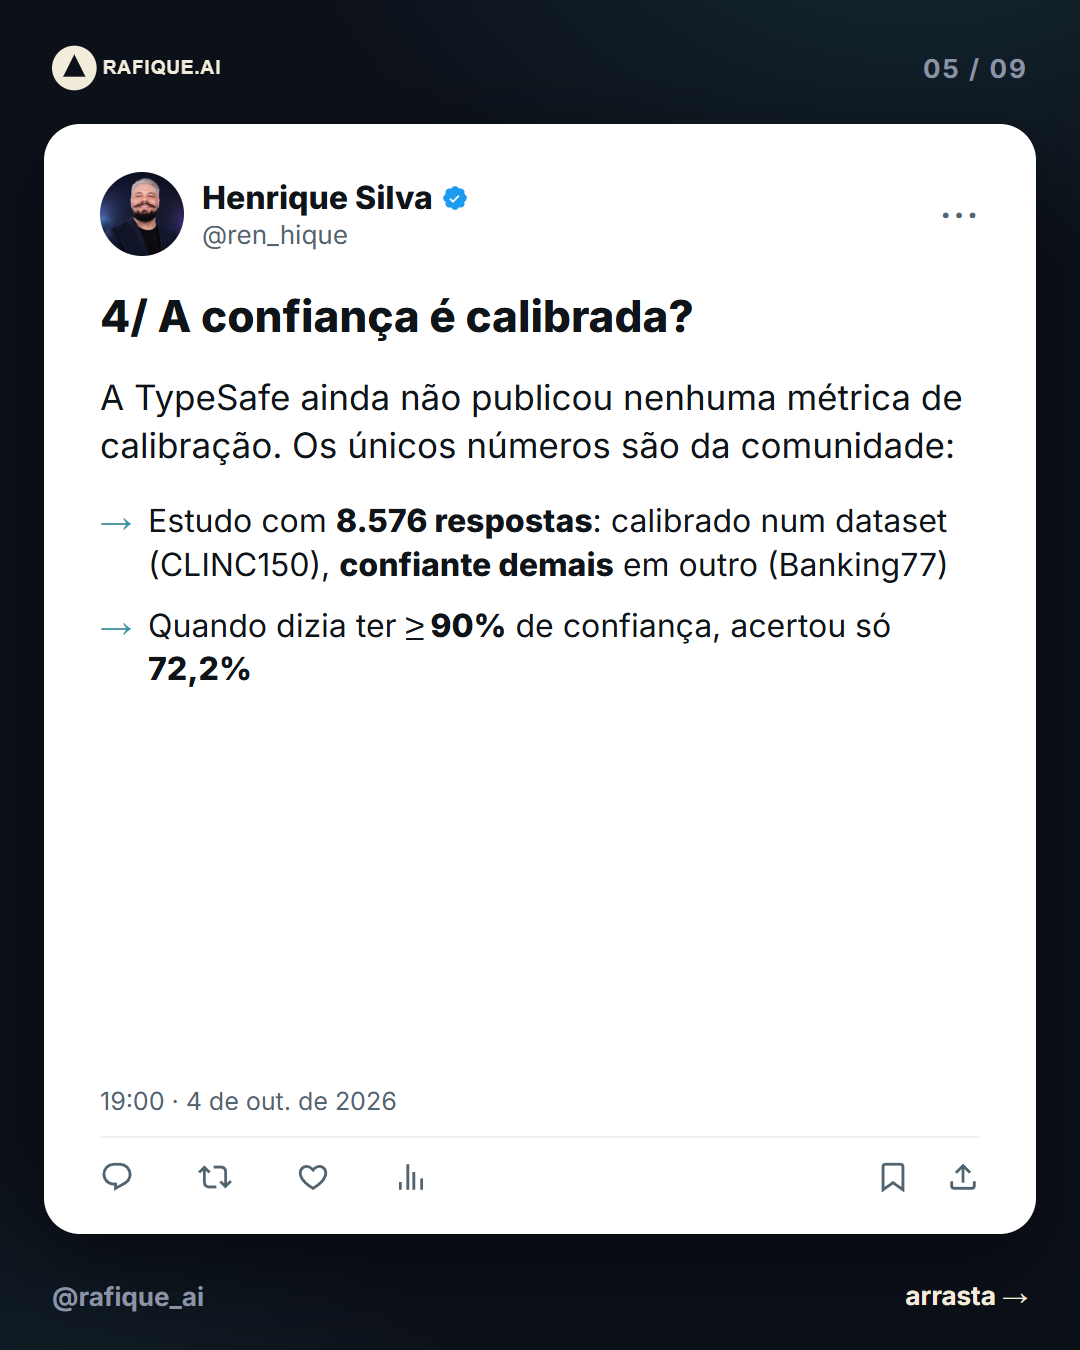
Os 9 slides do carrossel "Jev: hype vs realidade", publicado nas redes da Rafique AI.
Fontes
- TypeSafe AI — página inicial (números de velocidade e custo)
- TypeSafe AI — Introducing System One Models and Jev (15/09/2026)
- TypeSafe Docs — Jev 1.13 jaggedness (pontos fracos conhecidos)
- learnjev.com — linha do tempo de notícias
- systemonemodels.org — Jev vs Claude
- systemonemodels.org — Jev speed and pricing
- systemonemodels.org — Jev explained
Quer tirar decisões do LLM sem perder controle?
A Rafique AI desenha a divisão de trabalho (o que o LLM escreve, o que o Jev decide e o que o código executa), mede em traces reais e só coloca em produção com dono, limite e evidência.