NOVIDADE DE IA · 23/09/2026
Jev na prática: LLM escreve, Jev decide, código executa
O jeito certo de usar o Jev não é trocar o seu LLM, é dividir o trabalho. Primeira chamada, o padrão de agente, a conta real de 100 mil tickets por dia e os dois lugares onde ele engana: não é determinístico, e rotear tudo pode sair mais caro.
Depois do barulho do lançamento, a pergunta útil é: onde o Jev entra no meu sistema? A resposta curta é que ele não substitui o LLM. Ele tira do LLM as decisões pequenas e repetitivas — qual ferramenta, qual fila, sim ou não — que hoje custam uma chamada inteira de modelo grande, com latência de segundos e resposta em prosa para parsear.
Se você ainda não sabe o que é o Jev, comece por o que é o Jev. Aqui é mão na massa: a primeira chamada, o padrão de agente, a conta real e as armadilhas.
A primeira chamada: um endpoint, nada para parsear
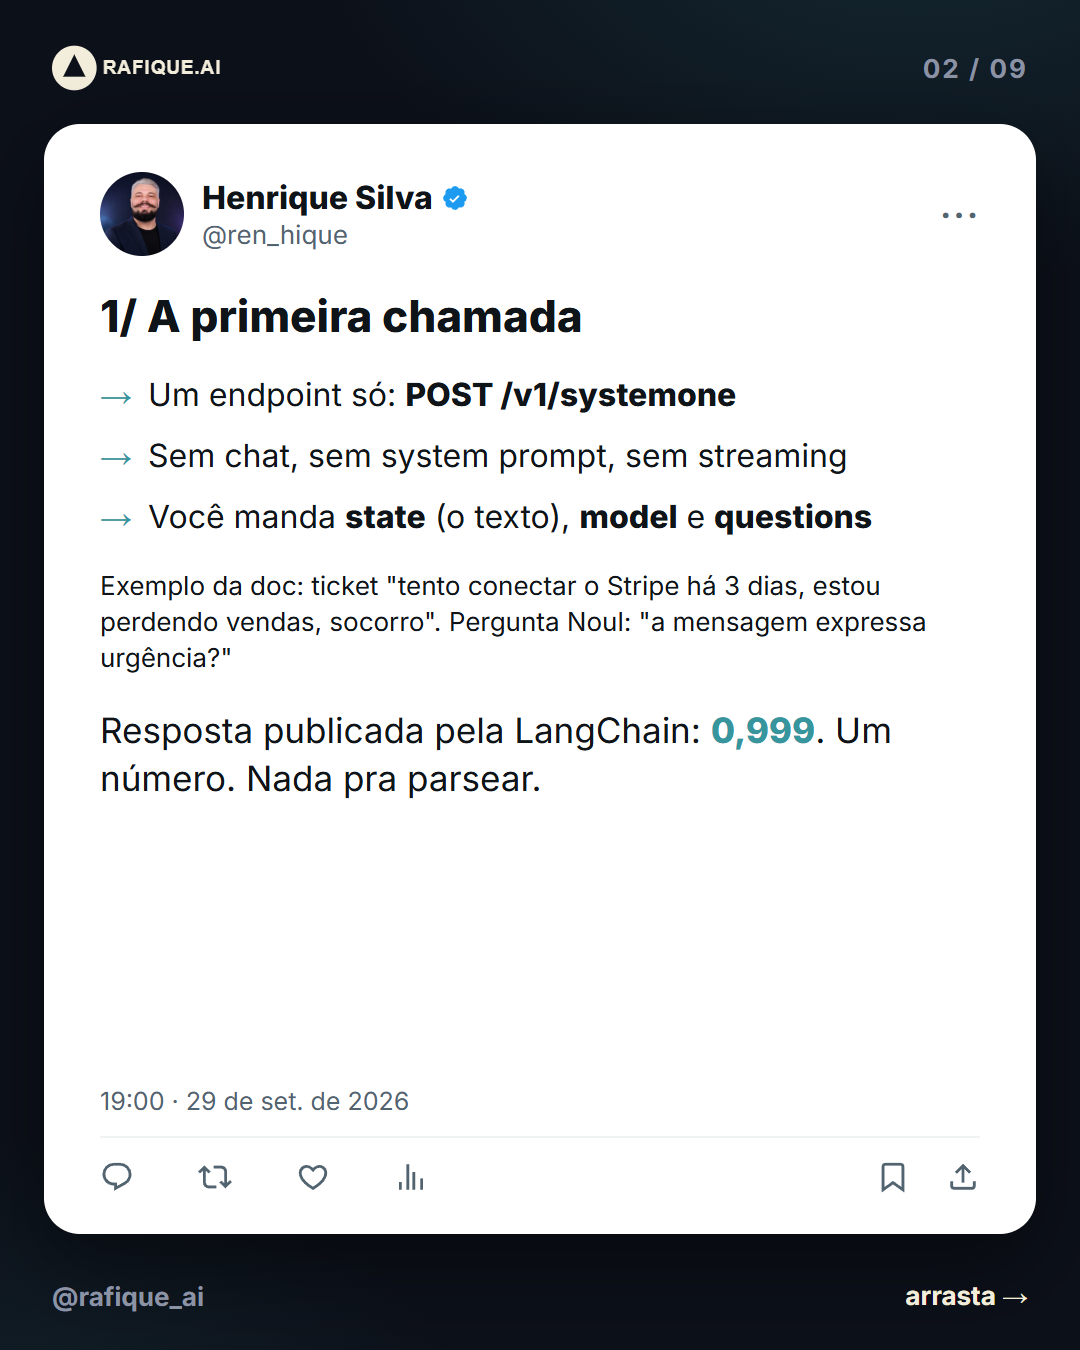
Crie uma conta em console.typesafe.ai, gere a chave de API no painel e chame POST https://api.typesafe.ai/v1/systemone com Authorization: Bearer. O corpo tem o modelo, o state (o texto a julgar) e as perguntas, cada uma com tipo e instruções:
{
  "model": "jev-1.13.0",
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the
            integration keeps failing. I'm losing sales. Please help ASAP.",
  "questions": {
    "department": {"type": "choice", "instructions": "Which team should handle this",
      "criteria": {"billing": "Payment or subscription issues",
                   "technical": "Bugs or integration problems",
                   "sales": "Pricing or account questions"}},
    "frustration": {"type": "score", "instructions": "How frustrated the customer appears",
      "criteria": ["Calm, just stating facts", "Frustrated but civil",
                   "Very angry, strong language"]},
    "is_urgent": {"type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"}
  }
}
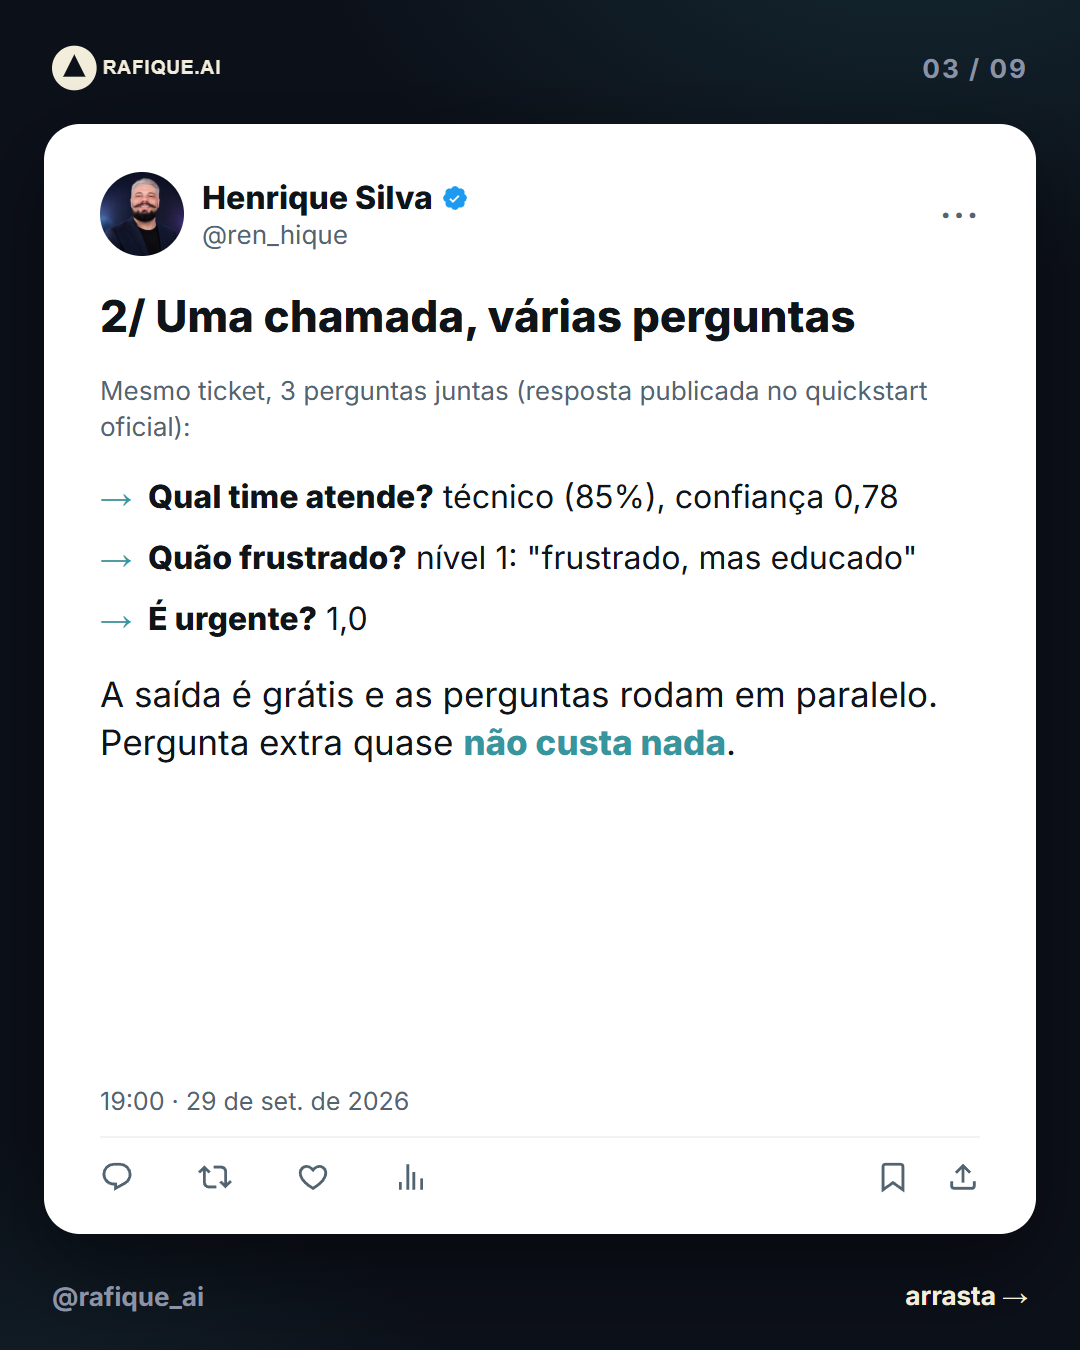
A resposta já vem tipada, pergunta por pergunta. No exemplo oficial do Quickstart:
| Pergunta (tipo) | Resposta do exemplo oficial |
|---|---|
department (Choice) | technical 0,85 · billing 0,15 · confiança 0,78 |
frustration (Score) | 1 — "Frustrated but civil" (frustrado, mas educado), confiança 1,0 |
is_urgent (Noul) | 1,0 |
| Uso | 392 tokens de entrada · 65 de saída (saída não cobrada) |
Exemplo de ticket de suporte sobre Stripe no Quickstart da TypeSafe.
Não há chat, system prompt nem streaming: é uma avaliação síncrona por request. Os SDKs oficiais são typesafe-sdk (Python) e @typesafe-ai/sdk (JavaScript), e existe um plugin oficial para Claude Code (typesafe-ai/skills). No Choice, criteria descreve cada opção; no Score, a lista define os degraus da escala, do menor para o maior. O exemplo está em inglês, o idioma principal do modelo.
Várias perguntas na mesma chamada, quase de graça
Como a cobrança é só na entrada, o custo de uma chamada é basicamente o tamanho do state. Fazer três perguntas sobre o mesmo ticket custa praticamente o mesmo que fazer uma. Isso muda o desenho: em vez de uma pergunta genérica ("classifique este ticket"), faça perguntas pequenas e específicas — departamento, urgência, frustração, "menciona cancelamento?" — e combine as respostas no código.
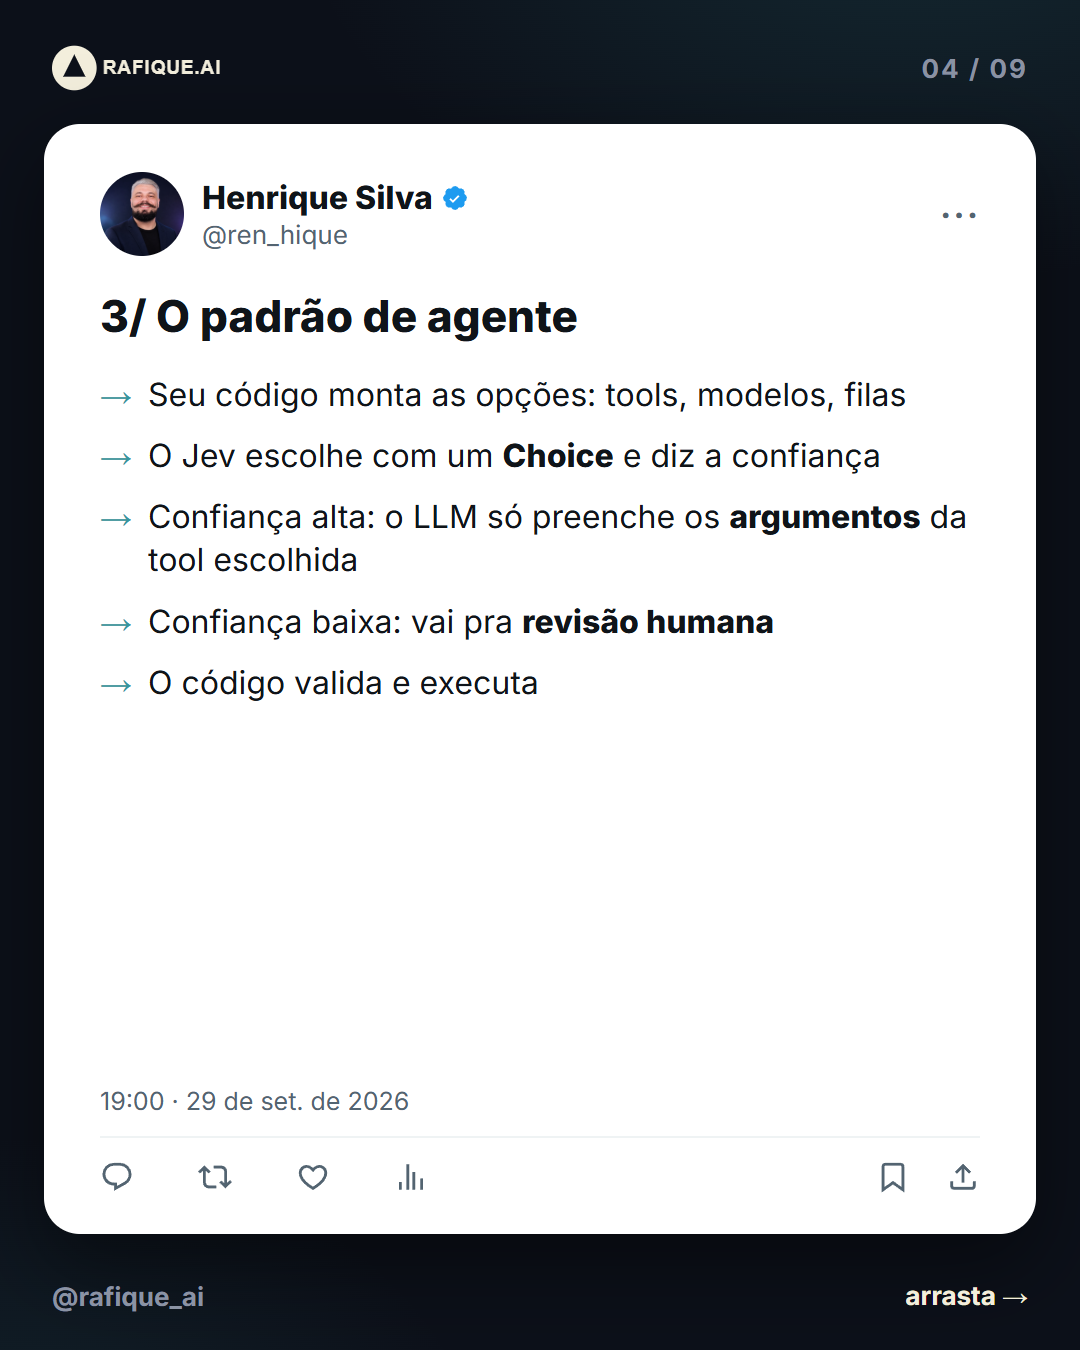
O padrão de agente: Jev escolhe, LLM preenche, código executa
| Se a tarefa… | Quem faz | Exemplo |
|---|---|---|
| Cria texto | LLM | Responder o cliente, preencher argumentos de uma ferramenta, gerar código |
| Escolhe, pontua ou responde sim/não | Jev | Qual ferramenta, qual fila, qual modelo, é urgente? |
| Segue regra exata ou tem efeito colateral | Código | Validar valores, somar, datas, executar o reembolso |
- Monte as opções a partir do estado real: ferramentas permitidas para aquele usuário, modelos disponíveis, rotas.
- Peça um Choice ao Jev (por exemplo, qual ferramenta usar).
- Se a confiança passar do seu limiar, o LLM só preenche os argumentos da ferramenta escolhida — um prompt bem menor.
- O código valida os argumentos, aplica a política de risco e executa, ou escala para uma pessoa.
- Use Noul e Score como guardrails: checagem de prompt injection, revisão de saída, "escalar para humano?".
A vantagem é previsibilidade: agentes com dezenas de ferramentas param de "adivinhar" o nome da função no meio de um prompt gigante. A seleção vira classificação sobre um conjunto conhecido. Mais detalhes da arquitetura em Jev Engineering.
Quem já está usando
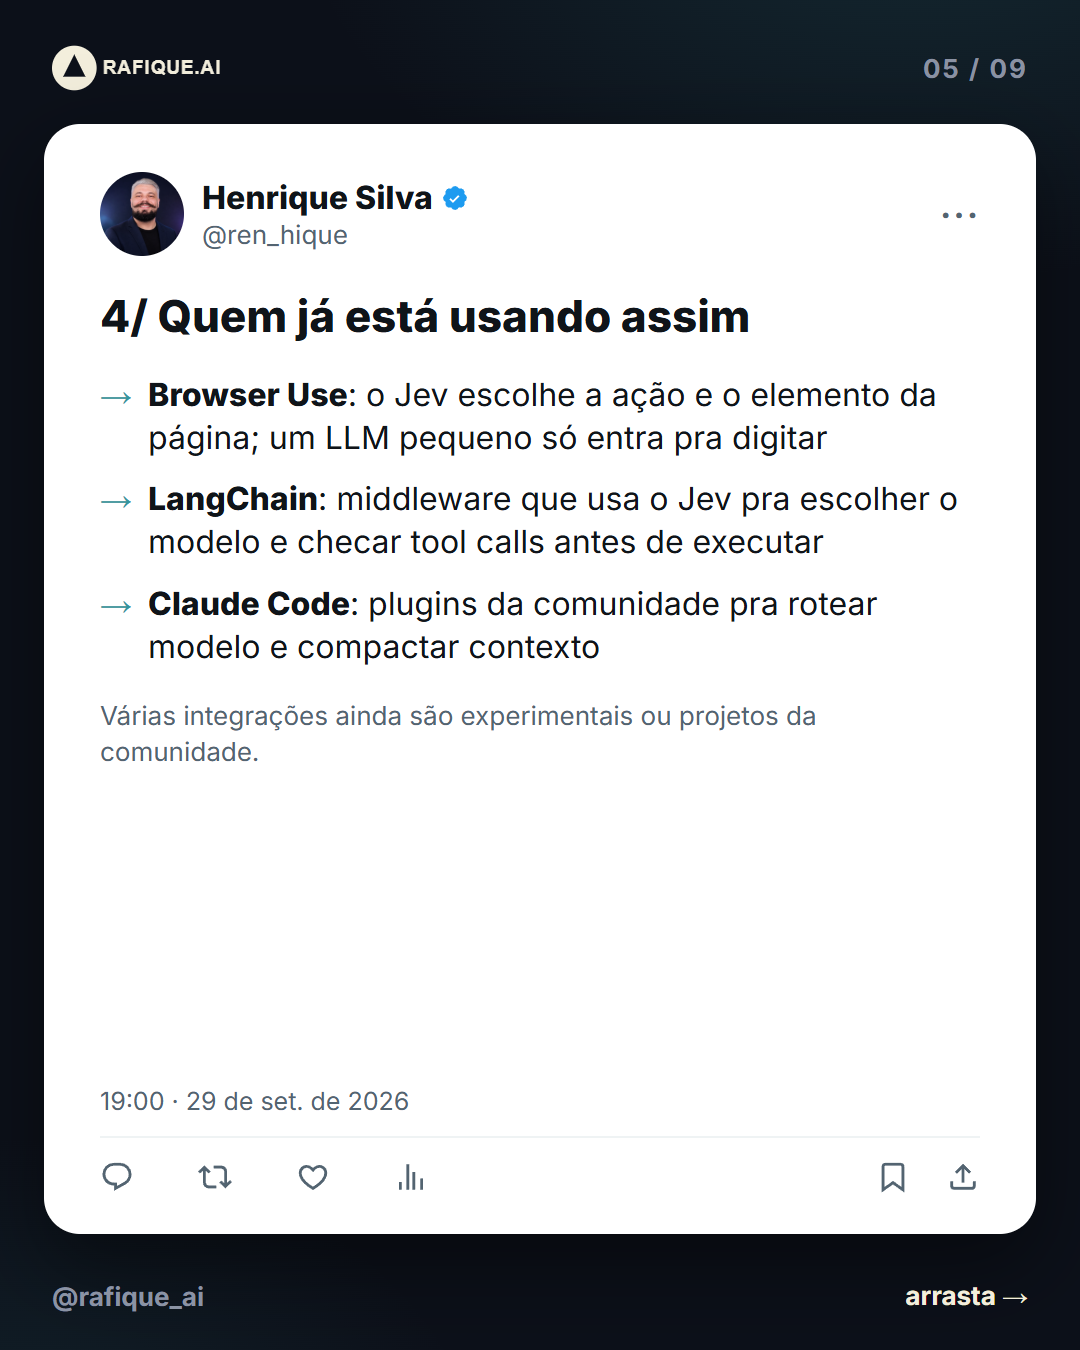
- Browser Use: o
jev-ultrafastusa o Jev para escolher a ação e o elemento da página; um LLM pequeno entra só para digitar texto. O repositório passou de 4.800 estrelas. - LangChain: o pacote
langchain-typesafetraz middlewares experimentais para roteamento de modelo (ModelRouterMiddlewareeAutoModeMiddleware). - Claude Code: além do plugin oficial, um plugin da comunidade que usa o Jev para decidir a compactação de contexto passou de 2.750 estrelas.
A conta real
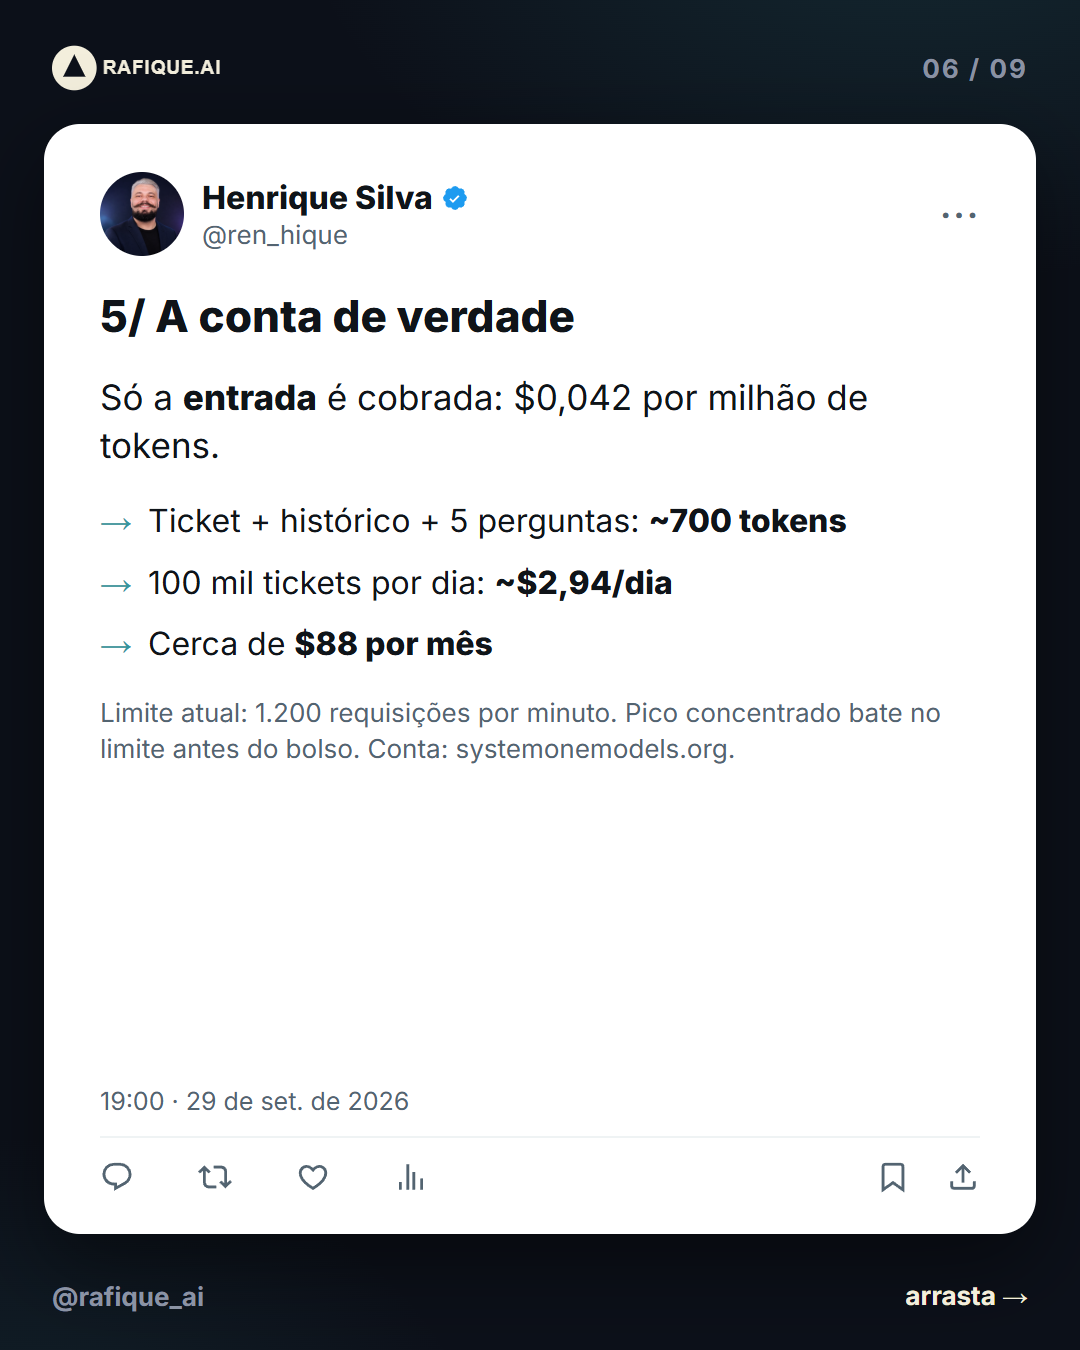
| Cenário | Custo estimado |
|---|---|
| 1 chamada de 700 tokens | ~$0,00003 |
| 100 mil tickets por dia | $2,94/dia |
| O mesmo volume no mês | ~$88/mês |
| Limite padrão da API | 1.200 requisições/min |
Conta do systemonemodels.org com o preço de $0,042 por 1M tokens de entrada.
Para triagem de suporte, moderação ou roteamento em volume, o custo do Jev é praticamente irrelevante perto do LLM que você já usa. O que custa de verdade é a engenharia: montar bons conjuntos de opções, rotular exemplos e calibrar o limiar.
Onde ele engana
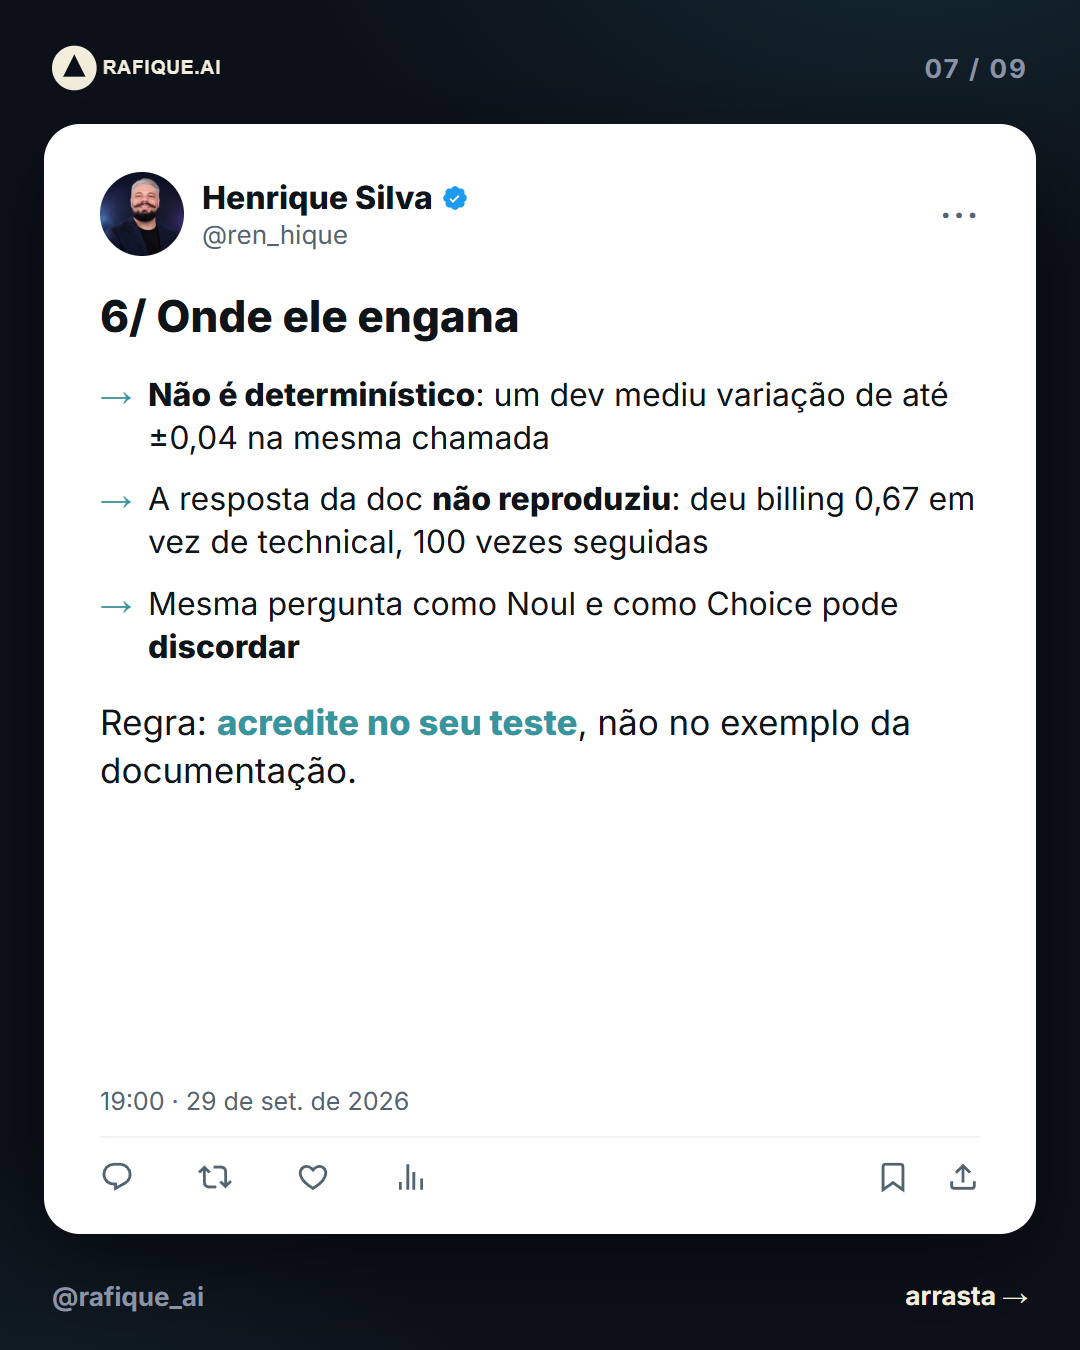
- Não é determinístico. Um desenvolvedor relatou que chamadas idênticas variaram até ±0,04 — ainda separando bem os casos claros (erros acima de 0,95, acertos abaixo de 0,10). Se o seu limiar é 0,80, uma resposta de 0,79 às vezes passa e às vezes não — deixe margem ou trate a faixa de dúvida à parte.
- O exemplo da documentação não reproduziu. No teste do learnjev, o exemplo do Quickstart devolveu billing 0,67 nas 100 execuções, e não technical 0,85. Há issue aberta. Não confie no exemplo; confie no seu teste.
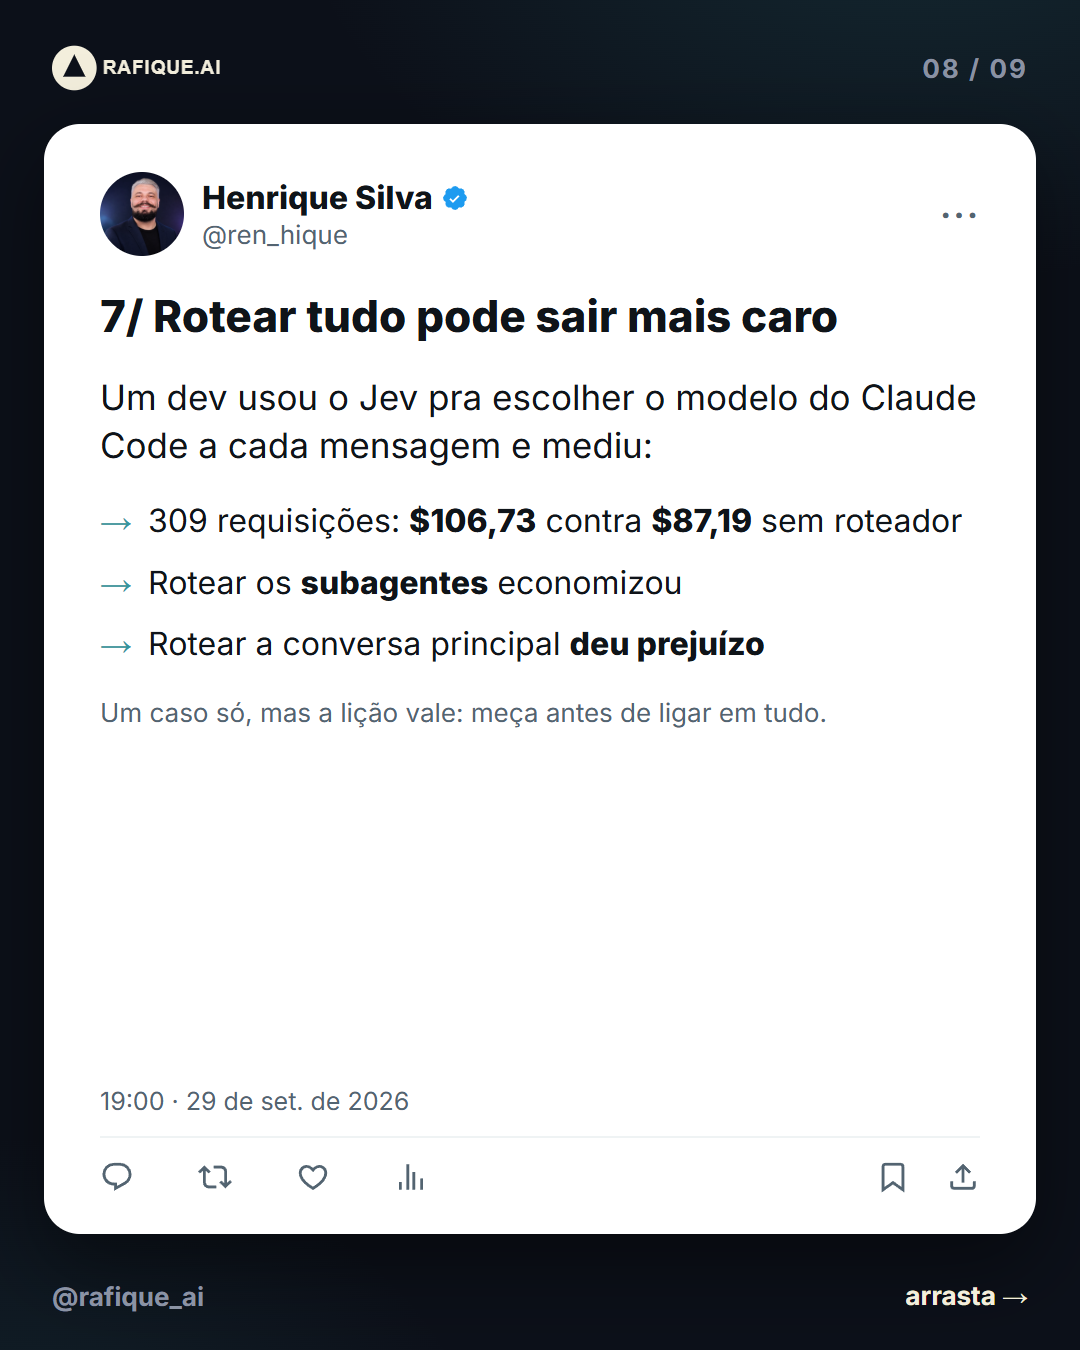
- Rotear tudo pode sair mais caro. Num caso publicado pelo systemonemodels.org, um roteador de modelos com Jev custou $106,73 em 309 requisições, contra $87,19 sem ele. De $19,53 de prejuízo, $17,12 vieram do chat principal, que passou a cair em modelos mais caros. Roteamento é decisão de negócio; meça antes.
- Idioma e contexto. Inglês é o idioma principal, e o state tem 32k tokens. Resuma históricos longos e teste em português.
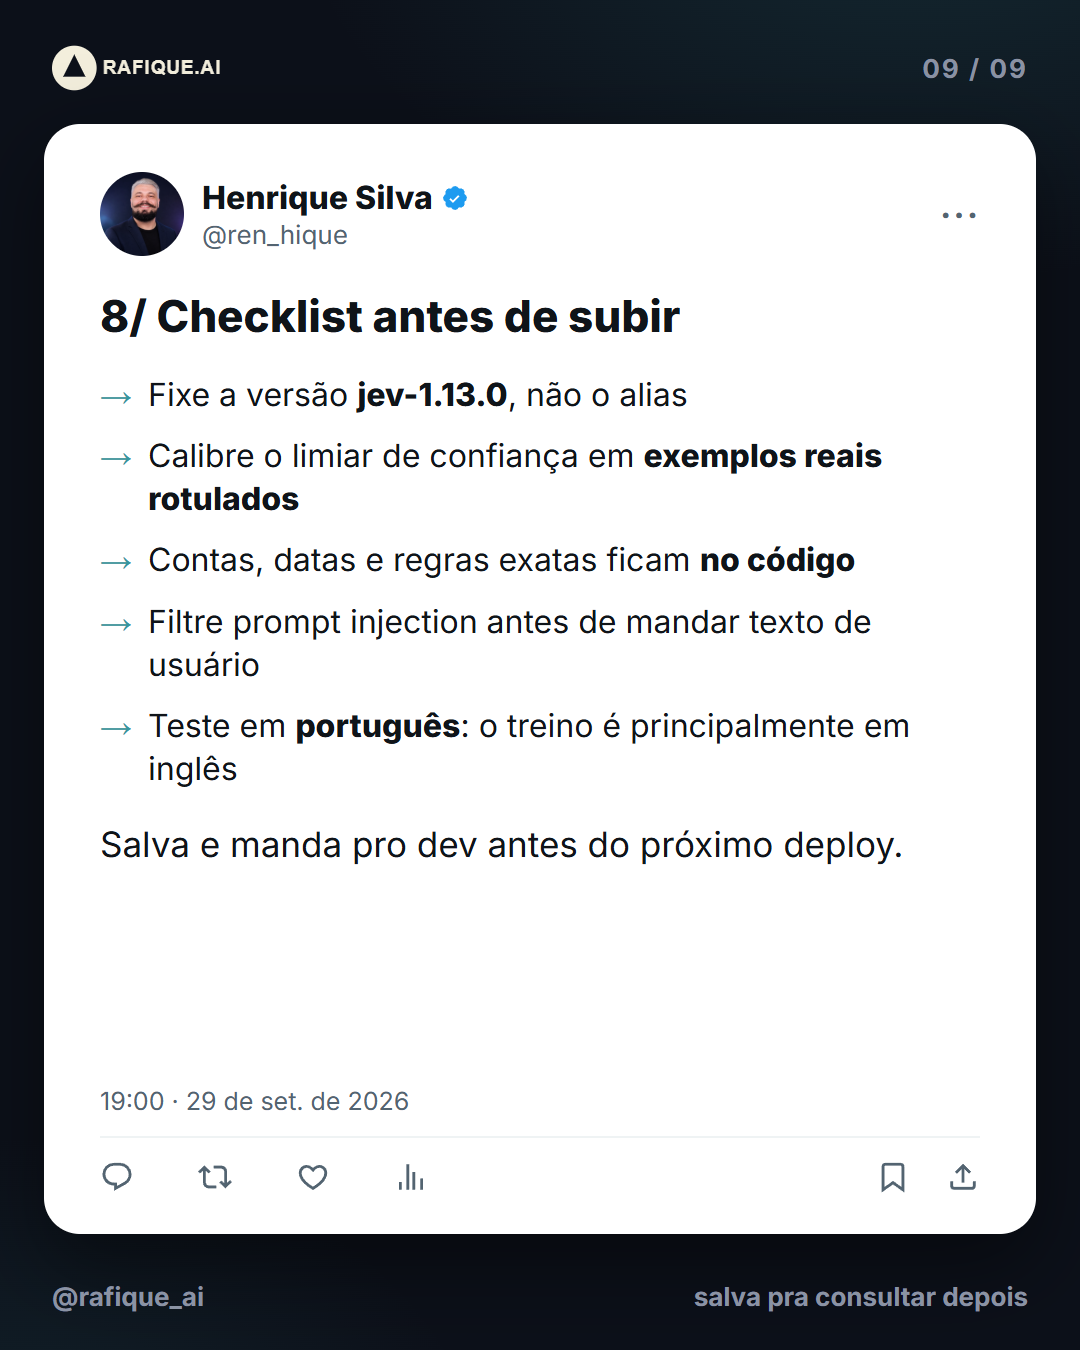
Checklist antes do deploy
- Fixe
jev-1.13.0; não usejev-latestem produção. - Calibre o limiar em traces rotulados do seu domínio, não no feeling.
- Tenha um caminho de fallback (LLM ou humano) para respostas abaixo do limiar.
- Não use o Jev como única camada de segurança: conteúdo adversarial é um ponto fraco documentado.
- Registre pergunta, resposta, confiança e versão do modelo em cada decisão.
Antes de adotar, vale ler também Jev: hype vs realidade.
O carrossel completo
Os 9 slides do carrossel "Jev na prática", publicado nas redes da Rafique AI.
Fontes
- TypeSafe Docs — Quickstart
- TypeSafe Docs — Models (jev-1.13.0, preços, limites)
- learnjev.com — tutorial: primeira chamada
- learnjev.com — linha do tempo de notícias
- systemonemodels.org — Jev speed and pricing
- systemonemodels.org — Jev vs Claude
- systemonemodels.org — página do modelo Jev
- Rafique AI — Jev Engineering: LLM escreve, Jev decide, código executa
Quer tirar decisões do LLM sem perder controle?
A Rafique AI desenha a divisão de trabalho (o que o LLM escreve, o que o Jev decide e o que o código executa), mede em traces reais e só coloca em produção com dono, limite e evidência.