NOVIDADE DE IA · 23/09/2026
Claude Opus 5.5 vs GPT-6 Astra: preço, benchmarks e quando usar cada um
A Anthropic lançou o Claude Opus 5.5 custando 2,5x menos por token que o GPT-6 Astra e na frente em código e trabalho de escritório na tabela oficial. Mas o Astra ainda ganha em ciência e automação entre apps — e preço por token não é custo por tarefa. O deep dive completo, sem hype.
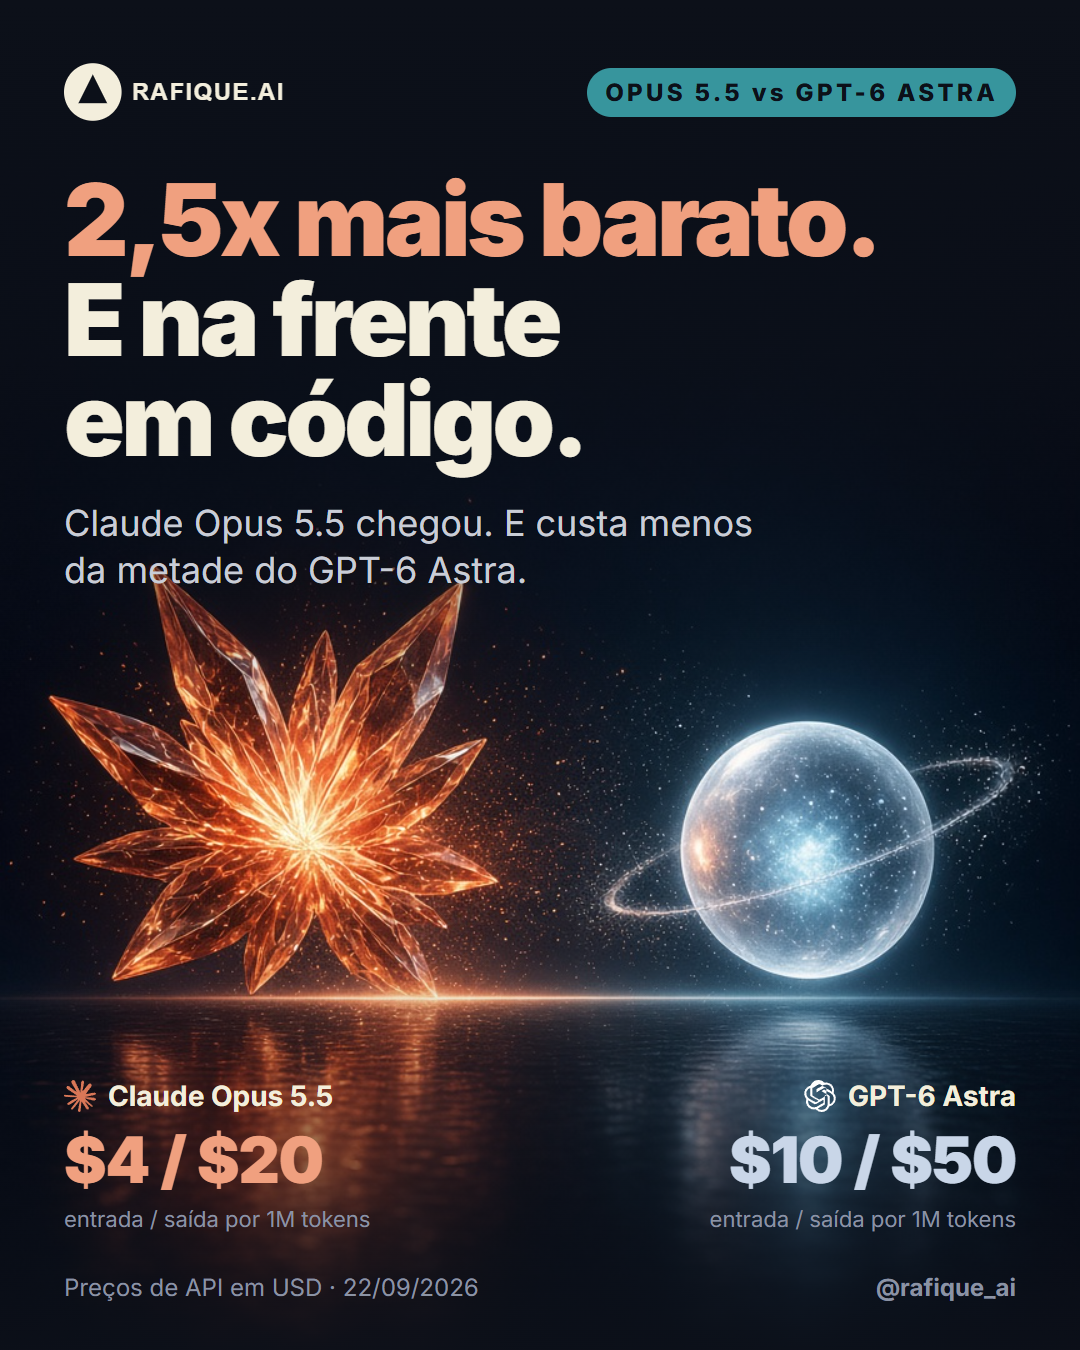

Em 22 de setembro de 2026 a Anthropic lançou o Claude Opus 5.5, primeiro modelo da família Claude 5.5 — e mirou direto no GPT-6 Astra, que a OpenAI lançou em 3 de setembro. A manchete é de preço: $4 / $20 por milhão de tokens contra $10 / $50 do Astra. Isso é 2,5x menos na entrada e na saída.
A segunda manchete é de desempenho: na tabela publicada no anúncio oficial da Anthropic, o Opus 5.5 fica na frente em código no terminal, em trabalho de escritório real e no Humanity's Last Exam. O Astra continua ganhando em pesquisa científica e, por pouco, em automação entre aplicativos.
Este guia junta o que importa para quem precisa decidir: o que é o modelo, a tabela de preços completa (incluindo a pegadinha dos 272K tokens do Astra), onde cada um ganha, por que preço por token engana, os casos reais publicados e o que muda para quem usa via API. No fim, um veredito por tipo de tarefa.
O que é o Claude Opus 5.5

- Família nova: é o primeiro modelo da família Claude 5.5. Sonnet 5.5 e Haiku 5.5 chegam "nas próximas semanas", segundo a Anthropic.
- Nível Fable na maioria das tarefas: a Anthropic diz que ele entrega o nível do Claude Fable 5.1 (o topo da casa) na maior parte do trabalho — e que, no uso interno, a distância é menor do que os benchmarks sugerem.
- Mais barato que o antecessor: custa cerca de 40% menos para rodar que o Opus 5 em cargas típicas. Entrada e saída caíram 20% ($5/$25 → $4/$20) e a leitura de cache caiu 60%.
- Mais rápido: gera saída mais de 30% mais rápido que o Opus 5.
- Janela grande: contexto de 1 milhão de tokens e até 128K de saída.
- Pensa sempre: o thinking adaptativo fica ligado o tempo todo; o parâmetro
effortcontrola a profundidade, e o padrão agora émedium.
Para assinantes do app Claude: os limites de 5 horas subiram nos planos Pro, Max e Team (e Enterprise por assento), e a Anthropic liberou um reset de rate limit que você guarda e usa quando quiser.
Preço: a manchete (e a letra miúda)

| Por 1M tokens (API) | Claude Opus 5.5 | GPT-6 Astra | Opus 5 (referência) |
|---|---|---|---|
| Entrada | $4 | $10 | $5 |
| Saída | $20 | $50 | $25 |
| Leitura de cache | $0,20 | $1,00 | 60% mais caro que o 5.5 |
| Escrita de cache | $5 (5 min) · $8 (1 h) | $12,50 | — |
| Batch | 50% off ($2 / $10) | 50% off (Batch/Flex) | 50% off |
| Contexto longo | 1M tokens, 128K de saída | ~1,05M; acima de 272K de entrada: 2x entrada e 1,5x saída na requisição inteira | — |
Fontes: documentação da Anthropic (Opus 5.5) e página do modelo GPT-6 Astra na OpenAI. Valores em dólar, sem impostos.
Dois detalhes mudam a conta mais do que a diferença de entrada e saída:
- Cache: a leitura de cache do Opus 5.5 custa $0,20 contra $1,00 do Astra — 5x menos. A própria Anthropic lembra que leitura de cache é a maior parte do custo em trabalho agêntico e de código, porque o agente relê o mesmo contexto a cada passo.
- Os 272K do Astra: se a entrada de uma requisição passa de 272 mil tokens, a OpenAI cobra 2x na entrada (e no cache) e 1,5x na saída da requisição inteira. Sessões longas de agente ou de computer use atravessam esse limite rápido.
Ainda existe o fast mode do Opus 5.5 (prévia de pesquisa, só na API da Claude): $8 / $40 por milhão de tokens por até 2,5x mais velocidade. Vale para latência crítica, não como padrão.
Benchmarks: onde cada um ganha
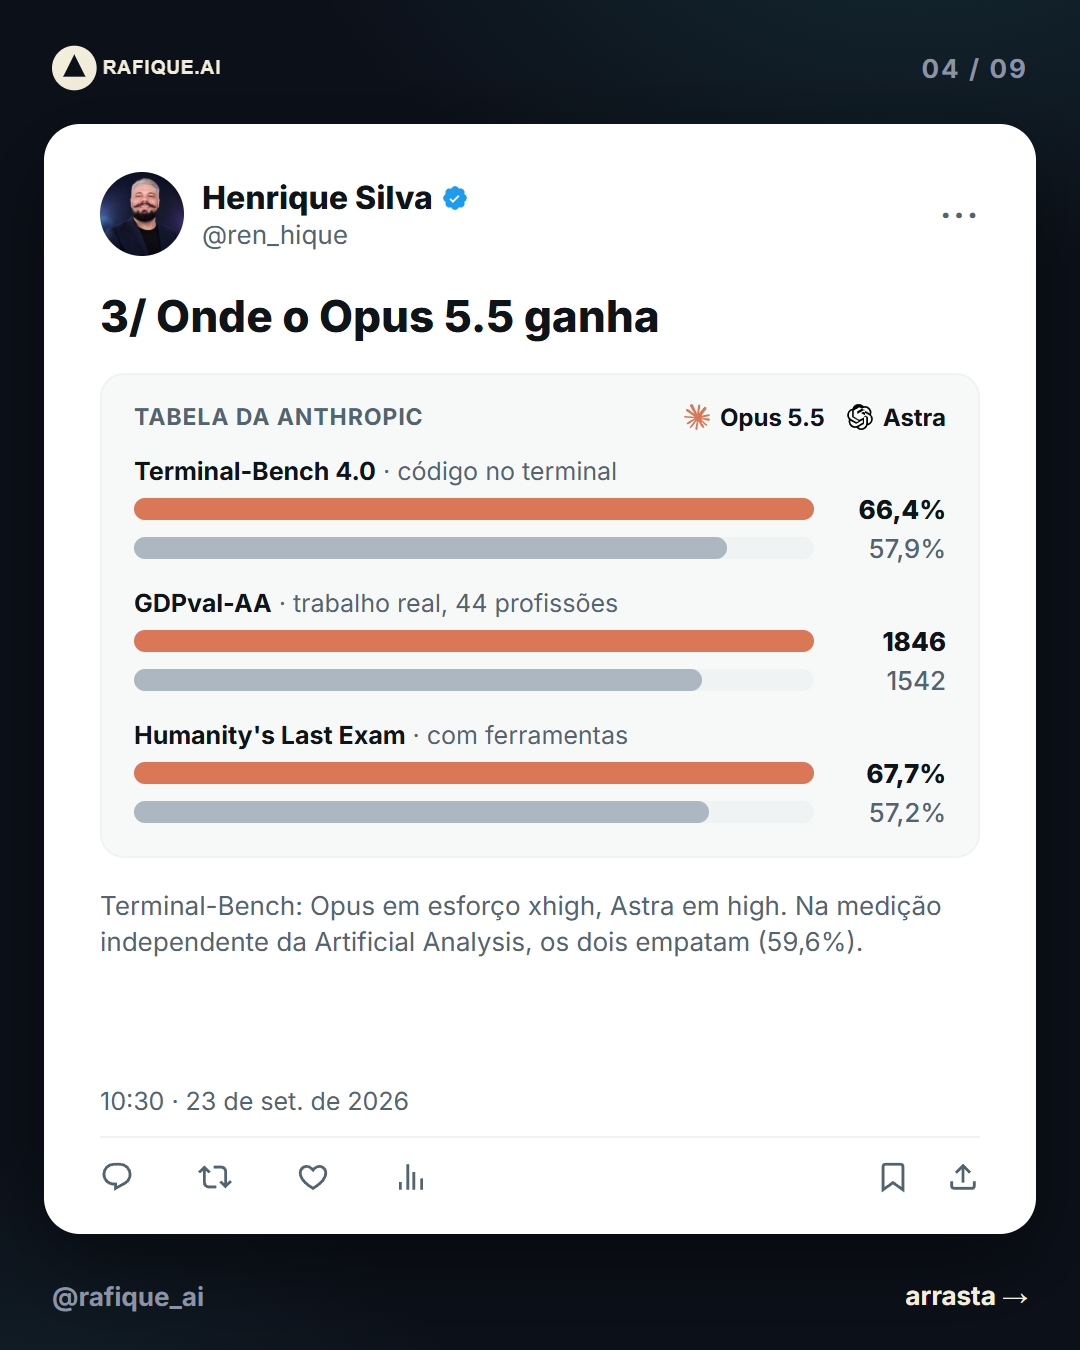
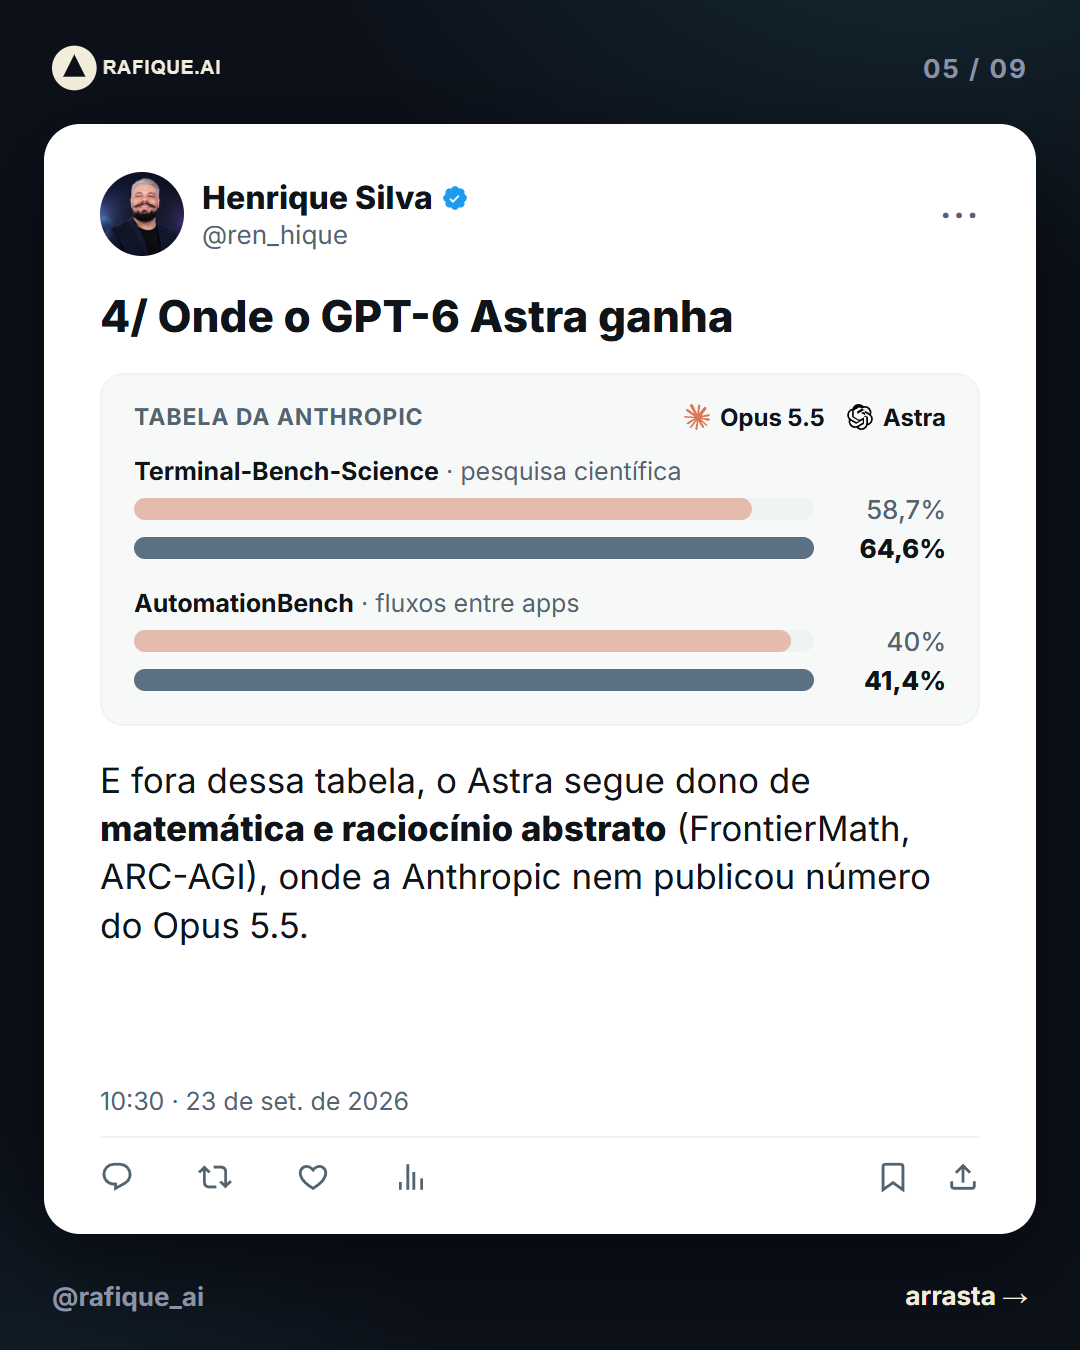
Slides 3 e 4 do carrossel: onde o Opus 5.5 ganha e onde o GPT-6 Astra ganha.
| Benchmark | O que mede | Opus 5.5 | GPT-6 Astra | Quem ganha |
|---|---|---|---|---|
| Terminal-Bench 4.0 | código no terminal, tarefas longas | 66,4% | 57,9% | Opus* |
| GDPval-AA v2.1 | trabalho real em 44 profissões (Elo) | 1846 | 1542 | Opus |
| Humanity's Last Exam | raciocínio multidisciplinar, com ferramentas | 67,7% | 57,2% | Opus |
| FrontierCode v1.1 | mudança de código que seria aceita (merge) | 54,4% | 53,3% | Opus (margem pequena) |
| AutomationBench | fluxos de negócio entre muitos apps | 40,0% | 41,4% | Astra (margem pequena) |
| Terminal-Bench-Science 0.1 | pesquisa científica agêntica | 58,7% | 64,6% | Astra |
Tabela publicada pela Anthropic; números do Astra conforme reportados pela OpenAI. *Opus em esforço xhigh e Astra em high (melhor nota de cada). Na medição independente da Artificial Analysis, os dois empatam no Terminal-Bench (59,6%).
Três ressalvas honestas antes de usar essa tabela para decidir:
- Esforço diferente no Terminal-Bench: a nota do Opus é em
xhighe a do Astra emhigh— a melhor de cada um. Na medição independente da Artificial Analysis, os dois empatam em 59,6%. - Salvaguardas ligadas: o Opus 5.5 foi avaliado com as salvaguardas de produção ativas. Quando elas intervieram, tarefas de cibersegurança foram resolvidas pelo Opus 4.8 e as de biologia e desenvolvimento de LLMs de fronteira pelo Opus 5. A Anthropic admite que isso provavelmente reduz a nota do 5.5.
- AutomationBench sem fallback: o teste foi rodado pela Zapier sem modelos de fallback, então toda intervenção de salvaguarda contou como falha. A diferença de 1,4 ponto para o Astra está dentro do ruído.
Fora dessa tabela, o Astra segue forte em matemática e raciocínio abstrato: a OpenAI reporta resultados perto da saturação em FrontierMath e ARC-AGI (detalhes no nosso guia do GPT-6 Astra), e a Anthropic não publicou números comparáveis do Opus 5.5.
Preço por token não é custo por tarefa

O Opus 5.5 pensa bastante. No esforço máximo, a Artificial Analysis mediu o modelo usando cerca de 119 mil tokens de saída por tarefa — umas 4x mais que o Astra. Com esse volume, a vantagem de 2,5x no preço de saída some.
Só que o esforço máximo não é o padrão. No esforço medium, a Anthropic diz que o Opus 5.5:
- supera a melhor nota do Astra no FrontierCode por ~20% do custo por tarefa;
- empata com o Astra no Terminal-Bench 4.0 por ~40% do custo;
- no GDPval-AA, bate o Astra em esforço máximo por cerca de um quinto do custo.
Tradução prática: deixe no medium e só suba o esforço quando a tarefa falhar. Fizemos a conta completa, com cache e exemplos numéricos, no artigo sobre custo real por tarefa.
Fora dos benchmarks: o que clientes relataram

- Auditoria de 200 mil linhas em menos de 3 horas. Um cliente de acesso antecipado auditou e corrigiu uma base desse tamanho; com o Opus 5 foram mais de 20 horas e 2,5x mais tokens.
- 18 horas sozinho. Um dev deixou o modelo rodando a noite toda numa tarefa de engenharia que atravessava seis repositórios. Segundo ele, o modelo bateu marcos mais rápido que o Opus 5 e exigiu pouco retrabalho.
- De 38 prompts em 4 dias para 11 prompts em 3 horas numa tarefa complexa de código, com saídas mais prontas para produção.
- 40 PRs empilhados rebaseados numa sessão que coordenou outras doze; todos passaram no CI no dia seguinte.
- HAProxy de C para Rust: no teste interno da Anthropic, o Opus 5.5 terminou em 9,5 horas contra 12 do Fable 5.1 e custou 51% menos. As duas versões passaram em quase todos os testes de regressão do próprio HAProxy.
São relatos publicados pela própria Anthropic no lançamento — sinal forte, não prova independente. O que eles mostram de novo é fôlego: tarefas longas sem se perder. Aprofundamos isso em agentes de 18 horas.
Usa via API? O que muda antes de trocar a string

Trocar claude-opus-5 por claude-opus-5-5 não é só mudar o ID. A documentação lista quatro mudanças que quebram requisições e uma que muda o formato da resposta sem dar erro:
- Thinking não pode mais ser desligado.
tool_choiceforçado (anyou uma ferramenta específica) retorna erro 400.- Blocos de thinking ficam presos ao modelo e à conversa.
- O computer use antigo
computer_20251124não é aceito na API da Claude e no Google Cloud; usecomputer_toolset_20260801. - A silenciosa: o texto entre chamadas de ferramenta chega em blocos de thinking vazios por padrão — se o seu app mostra "progresso", ele fica mudo.
E o esforço padrão caiu de high (Opus 5) para medium. Passo a passo com antes/depois no guia de migração da API.
Veredito: quando usar cada um

| Se a sua tarefa é… | Comece por | Por quê |
|---|---|---|
| Agente de código longo (refactor, migração, auditoria) | Opus 5.5 | Lidera Terminal-Bench/FrontierCode e custa bem menos por tarefa no esforço padrão |
| Trabalho de escritório em volume (relatórios, análises, documentos) | Opus 5.5 | GDPval-AA 1846 x 1542 e cache 5x mais barato |
| Pesquisa científica agêntica | GPT-6 Astra | Terminal-Bench-Science 64,6% x 58,7% |
| Automação entre muitos apps SaaS | Empate técnico — teste os dois | AutomationBench 41,4% x 40,0%, diferença dentro do ruído |
| Matemática pesada e raciocínio abstrato | GPT-6 Astra | OpenAI publicou resultados fortes; a Anthropic não publicou números comparáveis do Opus 5.5 |
| Biologia ou cibersegurança ofensiva | Nenhum sem programa de acesso | Ambos operam com salvaguardas e acesso verificado nessas áreas |
Modelo não é estratégia. A tabela dos laboratórios mede tarefas deles; a sua empresa tem as suas. O método que usamos na Rafique AI:
- Escolha 10 a 20 tarefas reais do seu fluxo (não prompts de demonstração).
- Rode nos dois modelos no esforço padrão, com o mesmo contexto e as mesmas ferramentas.
- Meça custo por tarefa concluída, incluindo retentativas e tempo de revisão humana — não preço por token.
- Suba o esforço só onde falhou e meça de novo.
- Decida por tipo de tarefa, não por marca. Muitas operações vão acabar com os dois modelos em rotas diferentes.
Leia também: segurança e pacing — por que o Opus 5.5 saiu com salvaguardas de nível Fable e o que isso muda para quem trabalha com biologia e cibersegurança.
Fontes
Quer escolher (e rodar) o modelo certo com método?
A Rafique AI testa modelos na sua tarefa real, mede custo por entrega e só coloca agente em produção com dono, limite e evidência.