NOVIDADE DE IA · 23/09/2026
Preço por token engana: o custo real por tarefa do Claude Opus 5.5 e do GPT-6 Astra
O Opus 5.5 custa 2,5x menos por token que o GPT-6 Astra. Isso não quer dizer que sua conta vai cair 2,5x. Modelo que pensa mais gasta mais — e cache, esforço e a regra dos 272K mudam o resultado. A conta completa, com exemplos.
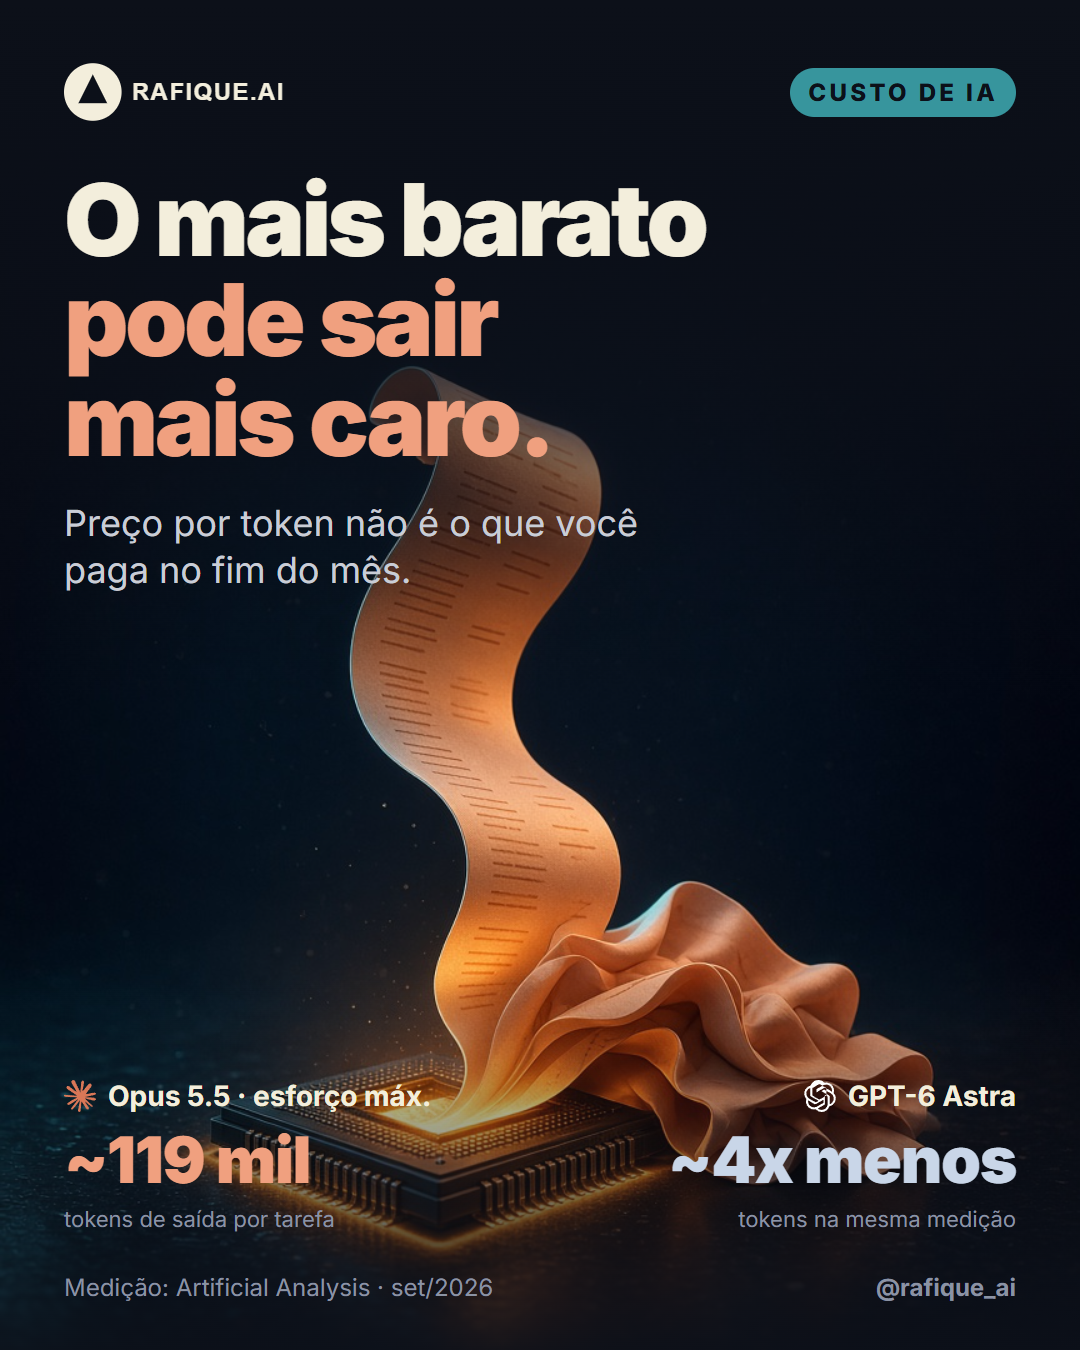
Toda vez que sai um modelo novo, a comparação é a mesma: uma tabela com preço de entrada e de saída por milhão de tokens. Nessa régua, o Claude Opus 5.5 ($4 / $20) é 2,5x mais barato que o GPT-6 Astra ($10 / $50) — e a manchete se escreve sozinha.
O problema é que ninguém paga "por milhão de tokens". Você paga por tarefa: o relatório gerado, o PR aberto, o ticket resolvido. E o custo de uma tarefa depende de quantos tokens o modelo gasta para chegar lá — o que varia muito entre modelos e, principalmente, entre níveis de esforço do mesmo modelo.
Este artigo faz a conta que importa antes de fechar o orçamento de IA do trimestre.
A tabela que todo mundo compara
| Item (por 1M tokens) | Claude Opus 5.5 | GPT-6 Astra | Diferença |
|---|---|---|---|
| Entrada | $4 | $10 | Astra 2,5x |
| Saída | $20 | $50 | Astra 2,5x |
| Leitura de cache | $0,20 | $1,00 | Astra 5x |
| Escrita de cache | $5 (5 min) · $8 (1 h) | $12,50 | — |
| Batch | $2 / $10 (50% off) | 50% off (Batch/Flex) | — |
| Modo rápido | $8 / $40 (até 2,5x mais rápido) | 2x o preço (fast mode) | — |
| Entrada acima de 272K | sem sobretaxa listada na doc do modelo | 2x entrada/cache e 1,5x saída na requisição inteira | pesa em agente longo |
Fontes: docs da Anthropic (Opus 5.5) e página do GPT-6 Astra na OpenAI. Confira sempre a página de preços oficial antes de fechar orçamento.
Até aqui, vitória larga do Opus 5.5. Agora vem a parte que a tabela não mostra.
A conta que importa
Custo por tarefa = (tokens de entrada × preço) + (tokens de cache × preço) + (tokens de saída × preço), multiplicado pelas tentativas até dar certo.
Três variáveis mudam de modelo para modelo:
- Tokens de saída por tarefa: modelos com raciocínio "pensam" antes de responder, e esse pensamento é cobrado como saída. Modelo que pensa mais gasta mais, mesmo sendo mais barato por token.
- Quanto do contexto vem do cache: em agente, o mesmo histórico é relido a cada passo. Se isso sai do cache, o preço cai muito.
- Taxa de acerto: uma tarefa que precisa de três tentativas custa três vezes — e ainda consome tempo de quem revisa.
O dado que derruba a manchete
A Artificial Analysis mediu o Opus 5.5 no esforço máximo usando cerca de 119 mil tokens de saída por tarefa — umas 4x mais que o GPT-6 Astra.
Faça a conta só da saída: 119 mil tokens a $20 por milhão dão cerca de $2,38 por tarefa no Opus. Um quarto disso (~30 mil tokens) a $50 por milhão dá cerca de $1,49 no Astra. No esforço máximo, a saída do "modelo mais barato" custa mais que a do concorrente.
Ou seja: se você migrar para o Opus 5.5 e colocar tudo no max "para garantir", a economia pode simplesmente não aparecer na fatura.
A virada: o esforço padrão
O Opus 5.5 vem com esforço padrão medium, e é aí que os números da Anthropic ficam interessantes:
- FrontierCode (se a mudança de código seria aceita): no
medium, 54,6%, acima da melhor nota do Astra (53,3%), por cerca de um quinto do custo por tarefa. - Terminal-Bench 4.0: no esforço padrão, empata com o Astra por cerca de 40% do custo — e supera o Opus 5 no esforço máximo por um quinto do custo.
- GDPval-AA (trabalho real em 44 profissões): no
medium, bate o Astra no esforço máximo por cerca de um quinto do custo.
Duas ressalvas: esses números são da Anthropic, e a documentação avisa que, no mesmo nível de esforço, o Opus 5.5 tende a pensar mais por turno que o Opus 5 — principalmente em xhigh e max. Se você migrar copiando o esforço antigo, refaça os testes; e deixe folga em max_tokens para o thinking.
| Tarefa agêntica típica* | Opus 5.5 (medium) | GPT-6 Astra | Opus 5.5 (max, ~4x saída) |
|---|---|---|---|
| 3,2M tokens lidos do cache | $0,64 | $3,20 | $0,64 |
| 200K tokens de entrada nova | $0,80 | $2,00 | $0,80 |
| Saída | 60K → $1,20 | 60K → $3,00 | 240K → $4,80 |
| Total por tarefa | $2,64 | $8,20 | $6,24 |
*Exemplo ilustrativo: 40 passos relendo ~80K de contexto em cache. Mostra a mecânica, não é medição. Se alguma requisição do Astra passar de 272K de entrada, ela fica mais cara.
Cache é a conta de verdade
A própria Anthropic diz que leitura de cache é a maior parte do custo em trabalho agêntico e de código. No exemplo acima, 3,2 milhões dos 3,4 milhões de tokens lidos vieram do cache — e é exatamente nessa linha que o Opus 5.5 é 5x mais barato ($0,20 x $1).
Para o cache trabalhar a seu favor:
- Mantenha o prefixo estável: instruções de sistema e definições de ferramentas no começo, sem mudar a cada chamada.
- Não edite o histórico: no Opus 5.5, mudar instruções no meio da conversa com mensagens de sistema preserva cache e thinking (veja o guia de migração da API).
- Escolha a duração da escrita: 5 minutos ($5) para sessões contínuas, 1 hora ($8) para fluxos com pausas.
- O prompt mínimo cacheável no Opus 5.5 é de 512 tokens.
A pegadinha dos 272K do Astra
No GPT-6 Astra, quando a entrada de uma requisição passa de 272 mil tokens, a OpenAI cobra 2x na entrada e no cache e 1,5x na saída — na requisição inteira, não só no excedente.
Exemplo: uma requisição com 300 mil tokens de entrada nova custaria $3,00 no preço normal; com a regra, vai para $6,00. Se ela gerar 20 mil tokens de saída, a saída sai de $1,00 para $1,50. Em sessões longas de agente ou de computer use, com screenshots e histórico se acumulando, essa linha é cruzada sem ninguém perceber.
O Astra tem janela de ~1,05M tokens, então a requisição não falha — só fica mais cara. Monitore o tamanho do contexto por chamada ou compacte antes de chegar lá.
Regra prática para o orçamento
| Cenário | Configuração recomendada |
|---|---|
| Padrão para quase tudo | effort: medium (é o default do Opus 5.5) |
| Tarefa falhou ou ficou rasa | Suba para high/xhigh só naquela rota e meça de novo |
| Relatórios, classificação, enriquecimento em lote | Batch (50% off) — tudo que não precisa de resposta na hora |
| Agente que relê o mesmo contexto | Prompt caching bem desenhado (prefixo estável, mínimo de 512 tokens) |
| Atendimento com latência crítica | Fast mode só nessa rota; o resto em modo normal |
| Sessões com contexto enorme no Astra | Monitore o limite de 272K por requisição ou compacte o contexto |
E a métrica que deve aparecer no seu painel não é "gasto com API", e sim custo por tarefa concluída: gasto total dividido pelas entregas que passaram na revisão. Ela já inclui retentativas, falhas e o esforço escolhido. É com ela que dá para comparar Opus 5.5, Astra ou qualquer modelo que venha depois — inclusive o Sonnet 5.5 e o Haiku 5.5, que a Anthropic promete para as próximas semanas e que podem ser a escolha certa para rotas mais simples.
Para o comparativo completo de capacidades, veja Opus 5.5 vs GPT-6 Astra.
Fontes
Antes de fechar o orçamento de IA do trimestre
A Rafique AI mede custo por tarefa nos seus fluxos reais, configura esforço, cache e batch por rota e entrega a conta em documento — não em achismo.