NOVIDADE DE IA · 28/09/2026
Claude Sonnet 5.5 x Opus 5.5: quando usar cada modelo
O Sonnet 5.5 superou o Opus 5.5 no Terminal-Bench 4.0 e custa menos por milhão de tokens. Veja o que os números mostram, onde o Opus ainda leva vantagem e como montar uma estratégia Sonnet primeiro.
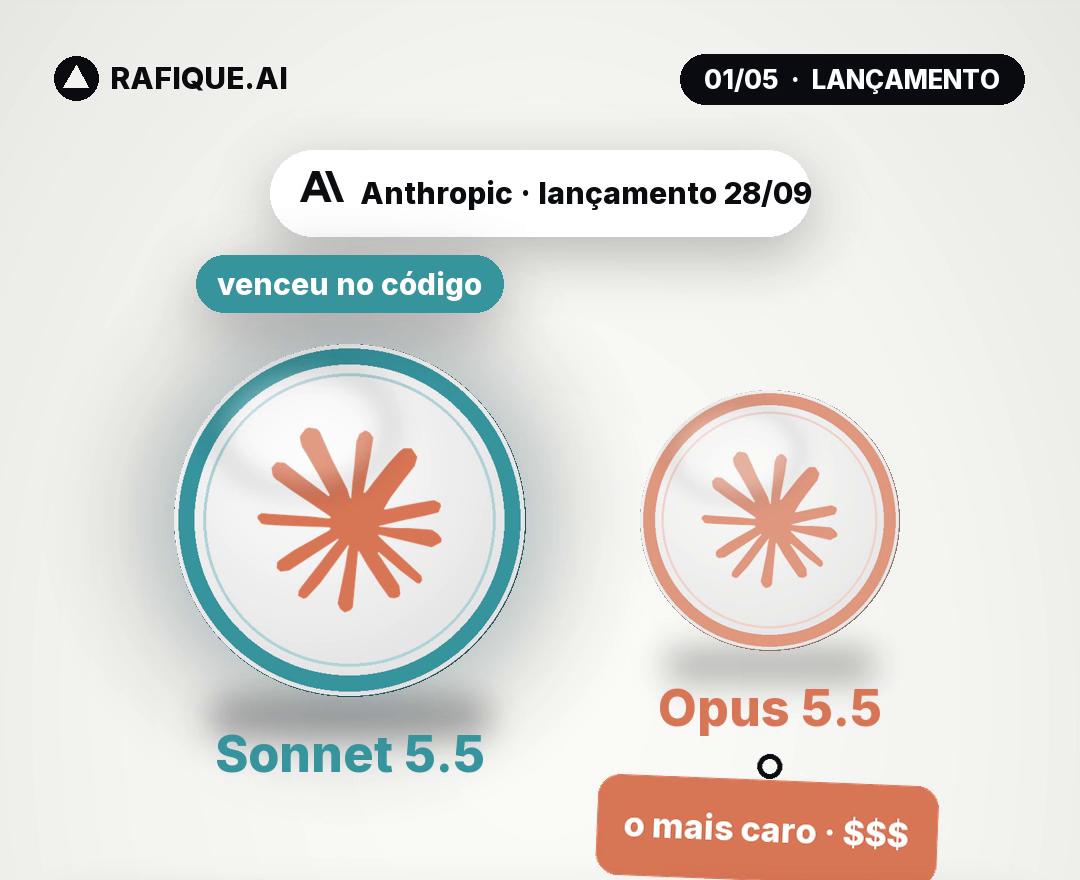
A Anthropic lançou o Claude Sonnet 5.5 em 28/09/2026, e ele passou o Opus 5.5, o modelo mais caro da própria Anthropic, no Terminal-Bench 4.0: 70,6% contra 66,4%. E custa metade: US$ 2 / US$ 10 contra US$ 4 / US$ 20 por milhão de tokens.
Só que o Opus ainda ganha em outros testes de código. Abaixo está a tabela oficial completa, o que cada número responde e a regra prática para escolher: Sonnet primeiro, Opus só onde ele errar.
| Benchmark | Sonnet 5.5 | Opus 5.5 | O que mede |
|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 66,4%* | Tarefa de código feita sozinha no terminal |
| FrontierCode 1.1 | 46,2% | 54,4% | Código de fronteira (tarefas difíceis) |
| CursorBench 4.0 | 55,5% | 57,8% | Programação dentro do editor |
| GDPval-AA v2.1 | 1844 | 1846 | Trabalho de escritório (pontuação) |
| OSWorld 2.1 | 80,1% | 81,8% | Uso do computador (resultado parcial) |
| Preço / milhão de tokens | US$ 2 / US$ 10 | US$ 4 / US$ 20 | Entrada / saída |
*Opus 5.5 no esforço máximo (Xhigh). Em negrito, o melhor de cada linha. Fonte: tabela oficial da Anthropic, 28/09/2026.
A diferença de custo muda a estratégia

Na comparação publicada, o Sonnet 5.5 aparece com valores de US$ 2 / US$ 10 por milhão de tokens, contra US$ 4 / US$ 20 do Opus 5.5.
Na prática, isso cria espaço para usar o Sonnet em tarefas de maior volume: geração de código, revisão, testes, documentação e primeiras tentativas de correção. O Opus pode ficar reservado para situações em que a qualidade adicional justifique o custo maior.
Regra operacional:
comece pelo Sonnet, observe o resultado e escale para o Opus apenas quando houver evidência de que a tarefa precisa dele.
O preço por token, sozinho, não determina o custo final. Também entram na conta o tamanho dos contextos, a quantidade de tentativas, o uso de ferramentas e o trabalho humano necessário para revisar a saída.
O que um benchmark realmente responde

Benchmarks são recortes de capacidade. Cada um testa um tipo de tarefa, ambiente ou critério de avaliação. Por isso, um resultado melhor em um teste não significa que o modelo vencerá em todo fluxo de desenvolvimento.
- Terminal-Bench 4.0: foi o teste em que o Sonnet 5.5 teve o melhor resultado entre os dois, com 70,6% contra 66,4%.
- FrontierCode 1.1: o Opus 5.5 venceu com 54,4% contra 46,2% do Sonnet 5.5.
- CursorBench 4.0: o Opus 5.5 venceu com 57,8% contra 55,5%.
- GDPval-AA v2.1 (trabalho de escritório): praticamente empate, 1846 contra 1844.
Se o seu caso de uso se parece mais com um benchmark em que o Opus vence, o custo menor do Sonnet pode não compensar uma taxa maior de erro ou retrabalho. A decisão correta depende do seu fluxo real.
O que não fazer com esses resultados

Não transforme o benchmark em promessa universal. O Sonnet venceu o Opus no Terminal-Bench 4.0 apresentado, mas o Opus venceu nos outros dois benchmarks mencionados no post.
Não escolha apenas pelo preço. Um modelo mais barato que exige várias tentativas pode custar mais no fluxo completo.
Não use o Opus como seguro automático para qualquer erro. Primeiro, descubra se o problema era falta de contexto, instrução ambígua, ferramenta quebrada ou ausência de teste.
Não dispense seu próprio teste. O melhor modelo para sua operação é aquele que entrega o resultado necessário, com custo e risco aceitáveis, no seu ambiente real.
A leitura mais útil dos dados é simples: Sonnet como primeira camada; Opus onde os testes e a natureza da tarefa justificarem.
Sonnet primeiro, Opus como fallback

A recomendação mais direta a partir desses dados é usar uma arquitetura em camadas, em vez de escolher um único modelo para tudo.
- Envie a tarefa para o Sonnet: use-o como primeira tentativa para tarefas de código e automação.
- Valide o resultado: rode testes, verifique o diff, confira a compilação e avalie se os critérios foram atendidos.
- Classifique a falha: diferencie erro simples de implementação, falta de contexto e tarefa realmente complexa.
- Acione o Opus quando necessário: encaminhe apenas os casos que falharem na validação ou que exigirem maior capacidade segundo seus próprios critérios.
- Registre o resultado: acompanhe qual modelo resolveu, quantas tentativas foram necessárias e quanto trabalho humano sobrou.
O ponto central é não usar o Opus como padrão por hábito. Use-o quando o fluxo indicar que a primeira camada não foi suficiente.
Exemplo de roteamento para um agente de código
Imagine um agente que recebe uma tarefa para alterar um repositório. O fluxo pode ser organizado assim:
- O Sonnet recebe a solicitação, o contexto necessário e as regras do repositório.
- O agente executa a alteração e gera testes ou atualiza os testes existentes.
- Uma etapa automática verifica falhas de teste, erro de compilação, alterações fora do escopo e ausência de arquivos esperados.
- Se a validação passar, o resultado segue para revisão humana.
- Se falhar, o sistema pode tentar uma correção com o Sonnet ou encaminhar o caso ao Opus, conforme a regra definida.
Exemplo de condição para escalonamento: falha persistente após uma tentativa, mudança em área sensível do sistema ou tarefa que exige raciocínio mais amplo. Essas condições são exemplos de implementação, não resultados informados pela Anthropic.
Checklist antes de escolher o modelo
Antes de trocar o modelo de produção, responda:
- Qual tipo de tarefa o agente executa com mais frequência?
- Existe teste automático para dizer se a resposta funcionou?
- O custo de uma falha é apenas retrabalho ou pode gerar uma consequência irreversível?
- O fluxo precisa de contexto muito grande ou de múltiplas ferramentas?
- Qual é a taxa aceitável de escalonamento para o modelo mais caro?
- Você consegue comparar modelos usando tarefas reais do seu repositório?
- Há revisão humana antes de uma alteração chegar à produção?
Sem validação, “Sonnet primeiro” vira apenas uma preferência. Com validação, vira uma política de roteamento que pode ser medida e ajustada.
O vídeo completo
O Reel "Claude Sonnet 5.5 x Opus 5.5" nas redes da Rafique AI (@ren_hique e @rafique_ai).
Quer avaliar o modelo certo para o seu fluxo?
A Rafique AI ajuda a transformar comparação de modelos em uma estratégia de roteamento com validação, fallback e controle de custo.